今天内核圈补的是两块「地基」:一边是争了很多年的接口——open(2) 终于能用 O_CREAT|O_DIRECTORY 一次原子地把目录建出来、并拿到一个钉住它的 fd ,填目录树的经典竞态有解了;另一边是内存——xswap 把「swap 设备必须预先定死大小」这个假设拿掉 ,让压缩 swap 随负载自己长大、自己缩回。此外 Qualcomm 的 VPU 驱动换成子节点描述 IOMMU,顺带给设备树添了个新属性 iommu-ranges。
🎬 今日导读 / section 头条 open(2) 新增 O_CREAT|O_DIRECTORY——建目录、拿 fd,一步到位(v6·12 帖)
头条 xswap:可伸缩的压缩 swap 设备,空闲时零内存成本(v2·12 帖)
media iris 把 iommus 拆成子节点,设备树新增 iommu-ranges(v4·13 帖)
DRM qxl execbuffer 四处越界一次性补齐(v2·4 帖)
fs kernfs 把活儿搬出写锁——创建/删除的写锁获取 1200 → 830
mm maple_tree 的 RCU 拆卸路径上埋着两颗雷(2 帖·带复现器)
net GSO 的 IP-in-IP 递归没有深度上界,非 root 用户可触达
Rust Rust UFS 驱动该不该绕开 SCSI 中间层?Greg KH 举了 USB 的前车之鉴
virtio virtio-blk 加 inline encryption,先立一个通用 control virtqueue
机制 kbuild 23 帖把编译单线程瓶颈薅秃:allmodconfig 最高快 36%
💡 今日头条 / section open(2) 新增 O_CREAT|O_DIRECTORY:建目录和拿到 fd,终于能一次做完 〔09-14 02:49 北京〕· [PATCH v6 00/12] vfs: add O_CREAT|O_DIRECTORY to open*(2)
现状 open(2) 早就有一条捷径:带 O_CREAT 打开普通文件,内核替你建好 inode 并返回一个 fd。目录没有对应的能力——想「建一个目录并拿住它」,只能先 mkdir(2),再单独 open(2) 一次。
痛点 两步之间是一条缝。填充目录树(解包镜像、装软件包、铺文件层级)时,通常要在建完之后再打开一次,去调权限、属主、ACL、xattr、安全标签、时间戳;而在这条缝里,目录可能已经被别的进程换掉了。没有正经 API,调用者只能事后 fstat 校验 inode 类型 / 属主 / 模式——既容易写错,也压根无法确认「这个目录是不是我建的」。
方案 给 open*(2) 定义 O_CREAT|O_DIRECTORY 这个组合的语义:执行一次 mkdir,把建出来的目录打开,并返回一个钉住(pinning)它的 fd——mkdir 本身不返回 fd,这是关键差别。主体工作在 namei.c 的 lookup_open();前面 6 帖先把 vfs_creat / vfs_mkdir_no_perm 抽出来复用、把 ->create 检查提前、父目录按 I_MUTEX_PARENT 加锁,作为铺垫。
为什么 有一处必须捆在一起改:禁止「以可写方式打开目录」的检查,目前是在 do_open() 很晚、inode 已经拿到之后才做。新语义下这会变成先建出目录、再报错失败。所以第 11 帖把 MAY_WRITE 的短路提前——代价是部分用户可见的错误码发生变化。另外 ->create / ->mkdir 不可用时的 errno 统一成 -EOPNOTSUPP,作者说这帖「可以砍,但砍掉会非常丑」。
效益 目录树填充第一次有了原子语义:建和持有是同一步,不需要事后自证身份。对容器运行时解包镜像、tar、overlayfs、包管理器这类高频建目录的路径收益最直接。
下一步 v6 已按 Christian Brauner 与 Neil Brown 的意见收敛(含悬空符号链接、粘滞目录、O_TMPFILE|O_CREAT 仍为 -EINVAL 的测试用例);作者提到 Neil 也在改同一条代码路径,希望能赶在大规模 rebase 之前推进。12/12 带 selftest。
一句话点评 看着只是把两个 flag 组合起来,实际逼着 VFS 把 namei 里一批历史包袱顺手理干净了——真正需要盯的是那两处用户可见的错误码变化。
🔗 原文
xswap:swap 设备第一次能自己长大、自己缩回,空闲时不占内存 〔09-13 15:50 北京〕· [PATCH v2 00/12] mm, swap: extendable swap devices (xswap)
现状 压缩 swap 有两条主流路径:zram 和 zswap。两者都要求**预先**把大小定死——分配时就得说清要多大,之后不能变。
痛点 大小静态意味着两难:按峰值预留就是长期浪费(尤其是内存紧张、还得跑很多容器的机器),按常态预留就是峰值时不够用。更别扭的是,负载缩小之后两者都不会把内存还回来——省下来的内存留在压缩池里,谁也用不上。
方案 xswap 是一个「没有后备存储」的 swap 设备:换出的页就住在 zswap 里,它的 cluster_info[] 数组放在一块 VM_SPARSE 的 vmalloc 区域,随用量伸缩。创建时只映射第一块,其余地址空间只做预留、不实际分配,所以一个空闲的 xswap 设备成本为零;增长由分配驱动(没有空闲 cluster 且地址空间还有余量就映射下一块),收缩由释放驱动(尾部空闲够多、已映射范围至多一半在用,就整块解映射,并留一块做缓冲以免下次分配立刻又映射回来)。
为什么 设计上最关键的一条约束是克制:cluster_info[] 仍然是一个普普通通的数组,访问还是 &si->cluster_info[offset / SWAPFILE_CLUSTER],没有每次访问一个分支、不需要 RCU 纪律、没有拆卸状态机、不会返回 NULL。省下的开销靠的是「懒惰映射元数据」,而不是把热路径改复杂。
效益 设备默认从 1xRAM 起步(向下取整到 cluster),因为映射是懒惰的所以这不要钱;管理面给了 /sys/kernel/mm/xswap/{create,destroy} 和每设备可选的 type<N>/limit 上限(单位页),设备在 /proc/swaps 里显示为 xswap<N>。实测 8 GiB 虚机、开 lockdep 与 PROVE_RCU,吞吐与普通 swap + zswap 相差 2-3% 以内——瓶颈本来就在 zswap 压缩,不在 cluster 表。
下一步 回写、rmap 查找这些是这套基础设施的消费者,作者已有一个 writeback 原型、准备作为参考发出来。v2 还砍掉了一个尺寸旋钮(原来的 debugfs 每设备限制没了,只留 type<N>/limit)。
一句话点评 把「swap 设备必须预先定死大小」这个长期假设拿掉,用的却是最小侵入的做法——保持数组访问形态不变这件事,比功能本身更值得学。
🔗 原文
📰 media / column ★ ★ iris 把 iommus 拆成子节点,顺手给设备树添了个新属性 iommu-ranges〔09-14 02:49 北京〕· [PATCH v4 00/13] media: iris: Migrate iommus to iris sub nodes
定位 Qualcomm 的 VPU(iris 驱动)通过多条 SMMU stream 做 DMA,而硬件对流的可寻址范围有硬性限制:non-pixel stream 只能碰 0-600MB 这一段 IOVA,pixel stream 才能寻址全域。问题是设备节点上单个 iommus 属性会把所有 stream 塞进同一个 IOMMU domain、共用一个 IOVA 分配器——于是没有任何机制保证 non-pixel 的 buffer 落在低 600MB 以内。
做法 真出事的话表现是未处理的 SMMU page fault,接着就是整机莫名重启(freedesktop 上的 issue 100)。早先是在驱动里预留 0-600MB 绕开,但地址范围限制本是某条 stream 的属性,就该落在那条 stream 上。v4 把一部分 stream 表示为子节点,各自绑定自己的可寻址范围(05-07 帖让驱动按 context bank 设备路由 buffer)。根子上还需要一个描述「设备自身的 IOVA 范围」的设备树属性。
效益 原有的 iommu-addresses 要 phandle、且隐含 reserved-memory 后备语义——可当没有任何真实内存预留时,它既不该放 reserved-memory 里,也不该要 phandle。于是引入新属性 iommu-ranges,由 iommu core 的 of_iommu 支持(04/13),schema 侧走 dt-schema PR 207。vpu3x 平台迁往子节点,iris3x 起步的新 SoC 一律按这个走;venus 老平台不迁。
和你相关 以后在设备节点上看到 iommu-ranges,别再当 reserved-memory 处理——它描述的是设备 IOVA 范围,不是系统共享内存。做 camera / VPU / IOMMU 的建议跟一下这条线。
🔗 原文
★ ★ Sony IMX681 颜色错:查到最后,问题不在内核里〔09-14 03:05 北京〕· Re: 图像错误定位(IMX681 / GNOME Snapshot 线程)
定位 有人报 Sony IMX681 在 GNOME Snapshot 里出图颜色不对,来回讨论了几轮。作者做了一次干净的对照实验:同一内核、同一驱动、同一 sensor、同一分辨率,只把 debayer 实现从 GPU 换成 CPU(LIBCAMERA_SOFTISP_MODE=cpu qcam),图像就正常了。
做法 结论是这个锅在 libcamera 的 GPU debayer,触发条件是「输入 stride 大于宽度」。作者实测 IPU7 的 ISYS video node 会把宽度向上取整到 32 像素的倍数——14 个宽度、无一例外;对方给出的 IMX681 数字能精确对上:width 3844 时 stride 为 7744 字节,也就是 3872 像素。
效益 这段 padding 是 ISYS node 加的,sensor subdev 根本没有 bytesperline 可设。而且这本就是标准 V4L2 的规矩:驱动可以 padding,消费者必须使用拿到手的 bytesperline。整个线程的价值在于先把问题定位到哪一段,再谈谁该改。
和你相关 相机链路排障的教科书案例——先隔离变量证明「同样的内核里换个实现就好」,再回到代码里找触发条件。
🔗 原文
📰 DRM / column ★ ★ qxl 的 execbuffer:一个 render client 就能踩的四处越界〔09-14 06:30 北京〕· [PATCH v2 0/4] drm/qxl: fix multiple missing bounds checks in execbuffer relocations
定位 qxl 是 QEMU 的虚拟显卡,它的 execbuffer ioctl 会直接处理用户提供的 relocation 条目——这部分校验不足,任何一个持有 DRM_AUTH 的 render client 都能触发内存安全问题。在虚拟化环境里,这条路径正对着 guest → host 的攻击面。
做法 v2 一次补齐四处:dst_offset 没对目标 BO 做校验;release 子分配器忽略请求大小、恒定用 256 字节槽位,而 ioctl 允许约 4088 字节的命令,会溢出写进相邻槽位;页未对齐的 relocation 能写穿单页 kmap 映射;src_offset 从 __u64 被静默截断成 int 且从不校验,会生成越界的物理地址。
效益 v1 是单帖,AI 评审(sashiko-bot)指出两个漏洞——dst_handle==0 时上界没算上写入宽度、通用的 BO 边界检查在 ILP32 上会溢出——v2 都修掉了,后三帖则是顺着这次评审在同一段代码里翻出来的老问题。
和你相关 虚拟化 + 用户态可控输入 + ioctl 的老配方,值得当安全补丁的阅读材料。
🔗 原文
★ ★ amdxdna:从固件取来的四个寄存器偏移,算出了边界却从不检查〔09-14 05:34 北京〕· [PATCH v2 0/2] accel/amdxdna: stale mailbox channel pointer, unbounded register offsets
定位 AMD NPU(accel/amdxdna)驱动从 NPU 固件读四个 mailbox 寄存器偏移,自己算出并保存了应该拿来校验的边界——然后从不校验。另一个问题是 mailbox channel 启动失败时会留下悬垂指针。
做法 补丁 1 在启动失败时清掉 channel 指针(修 use-after-free,必须排在边界检查之前);补丁 2 加上边界检查。
效益 这一对补丁的 cover letter 比补丁本身更值得读:作者明确写下这些值来自固件而不是用户态、他没有 PoC、没有复现、也无法在固件镜像里指令级定位产出代码,因此不对硬件「能不能报出 mailbox aperture 之外的偏移」做任何方向的断言。v1 被 AI 评审(Sashiko)以相当确定的语气指摘,作者的原话是不想让那个语气带进自己支持不了的结论里。
和你相关 证据边界的示范:能静态证明「保存了边界但没检查」,就不去延伸主张「攻击者可利用」。
🔗 原文
📰 fs / column ★ ★ kernfs:把活儿从写锁里搬出去,建/删节点的写锁获取 1200 → 830〔09-13 10:14 北京〕· [PATCH 0/3] kernfs: do less work under the kernfs_rwsem write lock
定位 kernfs_rwsem 是 per kernfs root 的——sysfs 和 cgroupfs 全机器各只有一把。每一次 create、remove、rename 都要拿写锁,写者持锁期间做什么,其他所有人就等多久。
做法 三帖各搬走一件事:① kernfs_add_one() 现在是挂上节点、放锁、再调 kernfs_activate() 重新拿锁;而 sysfs 不创建未激活节点,等于每个文件、每个目录白付两次写锁——改成放锁前先激活。② kernfs_rename_ns() 在锁内调 kstrdup_const(),这是 kernfs 里唯一在写锁下的 GFP_KERNEL 分配,意味着重命名可能持锁进入 reclaim——改成锁前分配。③ 同样在锁内用 kfree_rcu_mightsleep() 释放旧名字,其批量分配失败时(内存压力下正是如此)会退回 synchronize_rcu(),于是重命名可能持锁等完一个 grace period——改成解锁后释放。
效益 lock_stat 显示创建销毁五个 dummy netdev 的写锁获取次数从 1200 降到 830;KASAN 与 lockdep 下过了 kernfs selftest。这类「锁内少干活」的修补,正是 cgroup rmdir 延迟那类回归的同一片土壤。
和你相关 写内核的人可以直接抄这个思路:先量一遍持锁期间做了哪些本可以搬走的事。
🔗 原文
📰 mm / column ★ ★ maple_tree 的 RCU 拆卸路径上埋着两颗雷,作者留了最小复现器〔09-13 23:26 北京〕· [PATCH 0/2] maple_tree: fix maple_range_64 crashes in RCU mode
定位 作者在 RCU 模式下用 maple tree、但没设 MT_FLAGS_ALLOC_RANGE,内核崩了;换到上游内核排查后,定位到 RCU 拆卸路径上两个独立的问题。
做法 两者根因相同:一个没填满的 maple_range_64 节点,会把它最后一个 slot 挪去存元数据。补丁 1 移除 mt_clear_meta() 以修指针损坏,补丁 2 修 mt_free_walk() 的非法内存访问。
效益 作者如实说明:据他所知目前树内没有这种用法——所有用 MT_FLAGS_USE_RCU 的树也都设了 MT_FLAGS_ALLOC_RANGE,内部节点走的是 maple_arange_64,所以短期内打不到。但补丁带了可复现的最小测试程序,属于「先把地雷挖出来」的那类修复。
和你相关 低频路径上的潜伏崩溃——不设 ALLOC_RANGE 的 RCU 模式就是一个。
🔗 原文
📰 net / column ★ ★ GSO 的 IP-in-IP 递归没有深度上界,非 root 用户就能打到〔09-13 22:12 北京〕· [PATCH net 0/1] net: gso: limit recursive IP-in-IP segmentation
定位 net/core/gso.c 里,IP-in-IP 的 GSO 会重新进入 IPv4 / IPv6 的分段处理器,而这条路径没有深度上界——每一层嵌套的 IP-in-IP 头都会让分段器继续处理下一层内层头。
做法 给两个 handler 应用同一个深度界限,用 encap_level 累计已消耗的头部字节数来卡住递归。
效益 可达性不低:非 root 用户通过私有的 user + network namespace 就能触达,namespace-only 的复现器从 UID 65534 起步就能跑。作者的报告写得很克制——复现器和崩溃日志只覆盖了 IPv4 路径,IPv6 没有单独跑运行时测试;除了一句澄清性注释,最终源码改动很小。
和你相关 网络栈里「递归没有上界」是一类反复出现的模式,这段是可以直接对照的样板。
🔗 原文
📰 Rust / column ★ ★ Rust UFS 驱动该不该绕开 SCSI 中间层?Greg KH 讲了 USB 的前车之鉴〔09-13 21:44 北京〕· Re: [PATCH RFC] drivers/rufs: add Rust UFS host controller driver
定位 Rust 写的 UFS host controller 驱动(rufs)在 RFC 里做了一个显眼的选择:绕开 SCSI midlayer,直接建在 blk-mq 上。作者主动征求的正是「这么做行不行」。
做法 Greg KH 抬出了一段历史:很多年前 USB 子系统也用同样的理由绕开 SCSI midlayer,当时看着是「快速解法」,最后证明行不通、驱动被删掉了——「只要 UFS 还建在 SCSI 命令这些东西之上,就不该在一个独立驱动里试图复制它,无论一开始看起来多简单」。驱动作者回应:RFC 里 SCSI 相关代码不到 300 行、大多是结构体打包解包,真要用 bindgen 把结构体定义从 SCSI 层拿过来即可,算不上复制。Bean Huo 接着反驳:现在少,是因为难的部分这个 RFC 还没做到,不是 UFS 不需要——SCSI 逻辑也不只在 protocol/scsi.rs 里,upiu.rs 还要解码 SAM status。
效益 目前没有结论,而这正是 RFC 阶段该发生的事:趁 API 边界还没固化,先把「要不要新增一条平行的存储栈」谈清楚。
和你相关 想看内核里关于「该不该另起一套」的评审怎么吵,这个线程是活教材——而且它同时是 Rust for Linux 的边界问题。
🔗 原文
📰 virtio / column ★ ★ virtio-blk 加 inline encryption:先立一个通用的 control virtqueue〔09-14 00:16 北京〕· [PATCH v3 0/2] virtio-blk: Add inline encryption support
定位 带 inline crypto engine 的存储硬件(UFS / eMMC 那一类)在内核侧已经有 inline encryption 支持,但 virtio-blk 协议里没有对应能力——guest 里的虚拟磁盘要不到硬件密钥槽。
做法 v3 最关键的变化不是加密本身,而是先引入一条 control virtqueue,并把它定义成通用框架:它的缓冲区布局和队列位置与控制命令的内容无关。inline encryption 只是第一个使用者——能力发现(密钥槽数量、最大 DUN 尺寸、支持的密钥类型)与密钥管理(program / evict / derive_sw_secret / generate / prepare / import)全部走 control vq,而加密 I/O 请求仍然走请求队列;一个加密请求标识一个已 provision 的密钥槽,并携带 256-bit 的 DUN。
效益 这是打在 virtio 设备类型规范上的补丁(device-types/blk/description.tex 一次 +457 行),v3 还把 DUN 扩展成固定 4×64-bit 的数组。规范先行意味着内核驱动实现要排在后面,但 control virtqueue 这个新框架本身值得留意。
和你相关 做虚拟化存储的可以先看 control vq 的设计——它后面大概率会被别的控制类命令复用。
🔗 原文
📰 block / column ★ ★ blk-cgroup:让 bio 别再攥着队列本地的 blkg 不放〔09-13 14:55 北京〕· [PATCH v2 0/3] blk-cgroup: store blkcg in bio before blkcg_mutex conversion
定位 目前 bio 里直接存着 queue-local 的 blkg 引用,这带来两个麻烦:一个 bio 被重映射到别的设备时,必须丢掉旧引用、为新队列重建关联——哪怕没有任何 blkcg 策略需要它;而正在死亡的 blkg 会先从前面的查找树里消失,可 bio 上还钉着引用没排干。
做法 三帖分工明确:① 让 request_queue 成为权威查找方——队列自有的 rhashtable 按 blkcg 的 CSS ID 索引,让将死的 blkg 在引用排干之前一直可查,q->blkg_list 仍保留给有序遍历;② bio 改存并按队列无关的 blkcg CSS,queue-local blkg 由策略使用者惰性创建,钉到 bio 换设备或释放 cgroup 状态为止;③ 把 async bio punt 状态从 blkg 挪到 blkcg,让「只是 punt 一下」不再实例化 queue-local blkg。
效益 这是为 blkcg_mutex 转换铺路的准备系列(那一步要把 queue-local 的 blkg 拓扑同步从 q->queue_lock 挪到 q->blkcg_mutex)。v2 补了一处严谨性:所有 blkg rhashtable 查找都要求在显式 RCU 读侧临界区内,并用 __must_hold_shared(RCU) 标注,让 Clang 的线程安全分析来验证这个契约。
和你相关 设备重映射与 cgroup 死亡这两条本来最容易出竞态的路径,被拆成三小步处理干净。
🔗 原文
📰 PCI / column ★ ★ BE200 被 D3cold 拔了电就再也回不来:_PR3 切断了 M.2 的供电轨〔09-14 05:14 北京〕· [PATCH wireless v3 0/4] wifi: iwlwifi: recover the BE200 after D3cold removes its power
定位 在 Lenovo Yoga Pro 7 14IAH10 上,Intel Wi-Fi 7 BE200(8086:272b)过不了 D3cold:_PR3 会移除 M.2 模块的供电轨,等供电轨和 PERST# 一起回来时,网卡再也起不来了——链路训练不上,config space 一直读到 0xffffffff,只能重启。
做法 四帖:① probe 错误路径上取消 ME recheck work;② 别再用一个根本没落地的读去推断 CSME 是否存在;③ probe 时取消选择 product reset 模式;④ 在 .suspend 里 arm、在 .resume 里 disarm,如果 disarm 失败且设备读出来全是 1 就复位。
效益 前三帖带 Fixes: 和 Cc: stable,可以独立合并;第 4 帖没有 Fixes、是 Cc: stable+noautosel——因为设备在 D3cold 里死掉不是任何 commit 造成的回归,驱动从来就没处理过这件事。作者也坦白只有 BE200 一块卡可测,尽管第 4 帖的开关在该板子的 AML 门里同样接受 0x2526 / 0x271b / 0x2723 / 0x2725。
和你相关 笔记本 + 现代待机 + M.2 供电的老问题,这次是从固件的 reset 模式入手,而不是简单地把 D3cold 关掉。
🔗 原文
📰 LSM / column ★ ★ TIOCSIG 能绕开 Landlock 的信号域限制,但作者先问:这算 bug 吗?〔09-14 06:20 北京〕· [RFC PATCH 0/2] Landlock signal scope and TIOCSIG
定位 Landlock 文档里 LANDLOCK_SCOPE_SIGNAL 承诺把信号投递限制在同一或嵌套的 Landlock 域内。但一个被保留的 PTY master 可以用 TIOCSIG 把 SIGINT / SIGQUIT / SIGTSTP 送进域外的 slave 前台进程组——因为这条特权 TTY 信号路径根本不经过 security_task_kill()。
做法 这是一个 RFC,作者抛出的两个问题比补丁更重要:① 这该归类为 SCOPE_SIGNAL 执行不完整,还是文档里已经写明的「继承 TTY 描述符」限制?文档那一节谈的是 IOCTL_DEV 这个文件系统权限、而不是 SCOPE_SIGNAL;而且和已点名的 TIOCSTI / TIOCLINUX 不同,TIOCSIG 并不受 CAP_SYS_ADMIN 限制。② 如果算 bug,TIOCSIG 该走现成的 task_kill 钩子(补丁 1 演示的做法),还是该专门加一个 TTY 信号钩子?前者会让 SELinux、Smack、AppArmor、BPF LSM 也一并开始管这件事,作者明确说本系列不主张「跨 LSM 策略变更已经定案」。
效益 作者自评通用影响有限:CVSS:3.1 评分 3.8(Scope changed,只影响可用性)。
和你相关 先问清楚「这是不是 bug」,再讨论「该怎么修」——RFC 阶段该有的自我克制。
🔗 原文
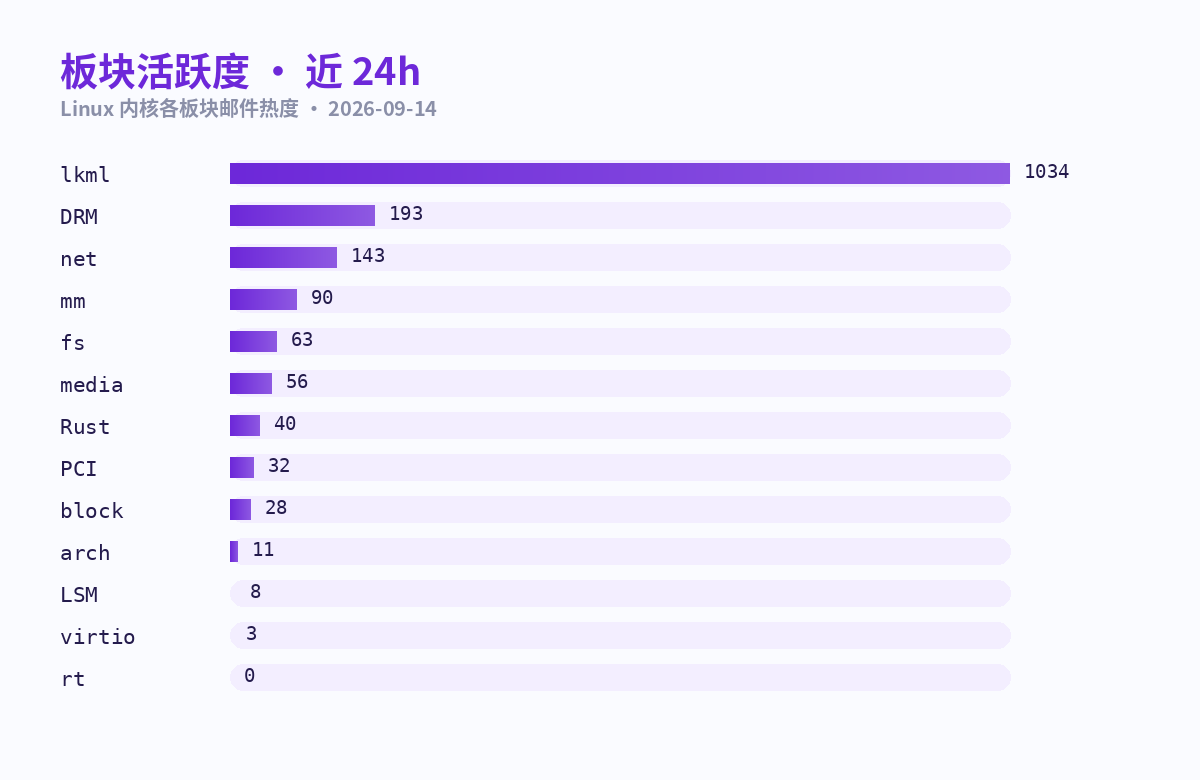
📊 板块活跃度 / column 近 24h 各板块真实热度(13 列表统一按最近 24h 计数):lkml 1034 · DRM 193 · net 143 · mm 90 · fs 63 · media 56 · Rust 40 · PCI 32 · block 28 · arch 11 · LSM 8 · virtio 3 · rt 0。DRM 今天异常活跃,主要来自面板驱动与 amdxdna / nova-core 的密集修补;rt 列表静默。
⚙️ 机制雷达:5 条跨域大改动 / section kbuild 提速 23 帖 把内核构建里的单线程瓶颈逐个薅掉:objtool 解码指令与解析分支目标并行化、modpost 的 srcversion 哈希并行、不再重复跑编译器与链接器探针、只在必要时产出 vmlinux 重定位、rustc 前端并行、有 pigz 就用 pigz 压缩。作者实测 allmodconfig 最高快 36%、增量构建约 70%、noop 构建约 90%;今天社区陆续贴出独立复现:EPYC 9454P 约 -13%、80 核 Ampere Altra 从 6h21m42s 到 5h31m15s(-13.22%)、32 核 AMD -11.7%。/\">讨论串 Linux 7.3-rc3 已发布 Linus 自述「又一个相当大的 rc」,这次文件系统足迹比平时大,主要落在 xfs 和 smb client,外加 netfs / afs 的修复(也有 erofs、btrfs)。大头仍是驱动侧,以 sound 和网络为主;其余散布在 core kernel、网络、landlock 修复与 selftest、以及 arch(主要是 s390 和 powerpc)。/\">原文 iommu-ranges 新属性 设备节点上的 IOVA 范围第一次有了准确的描述方式。旧的 iommu-addresses 要 phandle,且隐含 reserved-memory 后备语义;当没有真实内存预留时,它既不该进 reserved-memory、也不该要 phandle。随 media iris 系列引入,schema 走 dt-schema PR 207。/\">原文 btrfs 移除 v1 space cache 16 帖把老的 v1 空间缓存整套端掉:v1 的读写路径、SPACE_CACHE 挂载选项标志、free space inode 在 COW / delalloc / ordered extent 各处的一堆特例、btrfs_disk_cache_state,以及 TRANS_JOIN_NOLOCK。/\">原文 AI 评审开始进邮件列表 今天至少两个 v2 的直接触发者是 AI 评审(qxl 的 sashiko-bot、amdxdna 的 Sashiko)。有意思的不是 AI 找出了 bug,而是 amdxdna 的作者专门在 cover letter 里给评审语气「消毒」——不把那份确定性带进自己证据支持不了的结论。/\">原文
○ 更多动态 / column
📖 本期概念速查 / section pinning fd 一个「钉住」了某个文件系统对象的文件描述符——只要它还开着,对象就不会被回收。open(O_CREAT) 对普通文件返回的就是它,O_CREAT|O_DIRECTORY 想给目录补上同样的能力。
xswap / VM_SPARSE vmalloc xswap 是没有后备存储的 swap 设备,换出的页住在 zswap 里;VM_SPARSE 让 vmalloc 区域可以只预留地址空间、用到哪块才映射哪块,这是「空闲零成本」的来源。
IOVA / context bank / SMMU IOVA 是设备看到的虚拟地址(设备侧 DMA 地址);context bank 是 SMMU(ARM 的 IOMMU)里一个独立的地址转换上下文,每条 stream 可以各占一个,于是一台设备内部也能有不同的可寻址范围。
iommu-ranges 设备树新属性,用来描述「该设备自身 DMA 映射可用的 IOVA 范围」。区别于 iommu-addresses:后者要 phandle、用于 reserved-memory 里有真实内存后备的场景。
GSO / encap_level GSO(Generic Segmentation Offload)把大包的分段推迟到最后一刻;处理 IP-in-IP 这类带封装的头时会递归回到分段器,encap_level 记录已消耗的头部字节数,正是拿来给递归设上界的。
control virtqueue virtio-blk 新增的一条队列,专门跑控制类命令(如密钥管理)。它被定义成与具体命令无关的通用框架,缓冲区布局和队列位置都独立。
DUN / keyslot / inline encryption inline encryption 指存储硬件自带的加密引擎;keyslot 是设备里的密钥槽,DUN(Data Unit Number)标识数据单元、相当于给每块数据一个可推导的 nonce。
blkg / blkcg CSS blkcg 是块层的 cgroup;blkg 是每个「块设备 × cgroup」组合对应的策略对象,传统上是 queue-local 的;CSS 是 cgroup 子系统状态,与具体队列无关——把 bio 从钉 blkg 改成钉 CSS,正是这组补丁的核心。
RCU 模式 / maple_range_64 maple tree 是内核新一代的区间树,可运行在 RCU 模式下供无锁读者使用;maple_range_64 是它的一种内部节点,未满时会把最后一个 slot 挪去存元数据——两处崩溃都出在这个小动作上。
SCOPE_SIGNAL / TIOCSIG SCOPE_SIGNAL 是 Landlock 对信号投递范围的限制;TIOCSIG 是 TTY 的 ioctl,能让 PTY master 向 slave 的前台进程组发信号——因为走的是特权 TTY 路径,不经过 LSM 的 task_kill 钩子。
如果对你有用,点个赞,或留言聊聊你最关心的。
数据来源:lore.kernel.org(全内核 13 列表)· 北京时间
💬 评论
使用 GitHub 账号登录即可留言