今天内核最值得花 3 分钟看的两件事,一个在文件系统层、一个在内存管理:ext4 第 6 版把 buffered I/O 从 buffer_head 迁到 iomap——1M 大块顺序写最高提速 35%,这是 ext4 读写路径十年来最重的一次换血;另一边 Meta 的 RFC 揭穿一笔默认的浪费——共享内存映射里写 4K,回写时却可能刷出整页 2M,于是想给脏页跟踪装个「放大镜」,把记账细到子页。另有 vxlan 配置全面 RCU 化、面板与 bridge 两套抽象归一、PCIe endpoint 打通远端 DMA 一批机制在动。
🎬 今日导读
/ section 头条 ext4 buffered I/O 迁 iomap(v6·31 帖)——1M 大块顺序写 +35%、DONTCACHE 场景最高 +105%
头条 共享映射写 4K 却刷 2M:Meta 想把脏页跟踪细到子页(RFC·5 帖)
fs VFS 目录锁准备开刀(v3·6 帖)——从「锁父目录」走向「锁 dentry」
mm FS-DAX pmem 省 struct page 元数据——轻量沙箱 VM 起更快、塞更密
net vxlan 配置全面 RCU 化——转储 vxlan 不再死等 RTNL 全局锁
DRM 把 bridge 直接长进 panel(RFC v2·19 帖)——面板 / bridge 抽象归一
PCI PCIe endpoint 借 vNTB 打通远端 DMA(v4·7 帖)——主机直接读设备端内存
media ams OSRAM Mira016 传感器有 Linux 驱动了(v1·2 帖)
💡 今日头条
/ section ext4 给 buffered I/O 换引擎:iomap 接管读写回写,1M 大块写最快 +35%
〔09-03 20:43 北京〕· [PATCH v6 00/31] ext4: use iomap for regular file's buffered I/O path
现状 ext4 的 buffered 读写一直跑在 buffer_head 上:每个页块先读一块 buffer 元数据、再按 buffer 状态提交,一趟写要维护两套记账;而 xfs / btrfs 早已把文件数据 I/O 统一到 iomap(一次映射、批量下发到块的现代 I/O 框架)。read(2)/write(2)、mmap 写、回写(writeback)是文件系统最常走的路,却也是 ext4 离这套框架最远的一段。
痛点 buffer_head 路径每次都要为页上的 buffer 做状态管理、按块粒度拆 I/O,大 I/O 很难吃满块设备的顺序带宽;而且它跟 mm 的 large folio 演进步调错开——页缓存已经是 folio 的时代,block 级记账很多语义无处安放。
方案 31 帖(华为 Yi Zhang)按 iomap 重新实现 ext4 buffered 读、写、回写、mmap 与 EOF 部分块清零:前两帖先简化 truncate、去掉清零 EOF 块的多余 ordered I/O;03–20 帖扩展 ext4_map_blocks() 并把核心路径搬到 iomap;21–29 帖处理未对齐 EOF 文件增长时 i_disksize 的更新与 ordered 序列;30–31 帖用新 mount 选项 buffered_iomap 收口(默认关)。v6 rebase 到 7.3-rc1,主要是按评审修 bug。
为什么 不是推倒重写,而是给 ext4 一条能逐步替换的平行路径——inline data、fscrypt、data=journal、非 extent inode 等老特性还不能在 iomap 下全支持,先让两套引擎并存、遇特性自动回退到 buffer_head,才是「换发动机不熄火」的稳妥改法。
效益 实测大块吞吐明显见涨:64K/1M 顺序写 +9%/+35%(触发回写后 +30%/+15%),RWF_DONTCACHE(绕过页缓存复用)下 1M 场景 +105%;读路径基本持平或略升,仅小块同步 + 未缓存场景略有回退。
下一步 v6 等维护者收尾评审;后续目标是让默认配置也能安全启用、并补齐 inline / fscrypt 等特性。对写内核或做存储的,这是一份「大型文件系统整体换 I/O 框架」的分步改造范本。
一句话点评 用「双引擎并存、按需回退」把 ext4 最大胆的一次读写路径手术安全落地——比一步到位的重写更值得学
🔗 原文
共享映射写 4K 却刷 2M:Meta 想给脏页跟踪装个「放大镜」
〔09-04 02:29 北京〕· [RFC PATCH 0/5] mm: sub-folio dirty tracking for PTE-mapped mmap writes
现状 经过共享内存映射(file mmap)写数据,脏页靠页表 dirty 位 + 每个 folio 一个脏标志记账,回写时把脏 folio 整个写出去。页缓存 folio 可以很大(能到 2M),但写路径通常只改其中一小段。
痛点 共享映射里一次 4K store 会把整个 folio 标脏——folio 越大浪费越夸张:一次 4K 写入变成 2M 写回,而写回又不知道到底哪段变了。想在 page_mkwrite 时只标当前页也不行:首次共享写缺页时 set_pte_range() 会把整个 folio 一次性批量映射成可写,之后的 store 根本不再触发缺页。
方案 换个思路,从硬件那端回收信息:folio_clear_dirty_for_io() 本来就会调 folio_mkclean(),它的反向映射遍历逐个读 folio 各 entry 的 pte_dirty()——这些位正是「映射上到底写了哪些子页」的唯一记录,此前却被直接丢弃。5 帖(Meta Kiryl Shutsemau)把这批位收集起来,经新增的 a_ops->dirty_folio_range() 交给文件系统;xfs 侧按块记 mmap 脏状态,回写只刷脏区段。
为什么 不在缺页路径上硬打补丁(拦不住批量映射),而是复用一个已经存在的硬件位遍历、把原本丢掉的信息变成可用的干净数据——改动集中在 mm/rmap 与 page-writeback,文件系统只需接新回调。PMD 映射的 2M 只有一个脏位、没有更细信息可采,仍整体回写(留待单独补丁)。
效益 基准:512M 文件按 2M folio 存储、每个 folio 写 1 字节后 msync(),此前要回写 512M,之后仅回写约 1M。对「映射大文件随机小块写」的工作负载,写放大可骤降几个数量级。
下一步 仍是 RFC:脏记账(dirty_ratio / balance_dirty_pages)仍按整 folio 算、iomap_page_mkwrite 仍按整 folio 分配块、无逐块脏状态的文件系统不受影响——这些留待后续。方向很明确:把 writeback 的粒度从 folio 再往子页抠一层。
一句话点评 一次 4K 写入动辄拖出 2M 写回——把这种隐形的写放大摆上台面,是 large folio 时代 mm 迟早要还的一笔账
🔗 原文
📰 fs
/ column ★ VFS 目录锁要换主人:从「锁父目录」走向「锁 dentry」
〔09-03 11:24 北京〕· [PATCH v3 0/6] VFS: prepare for changes to directory locking
定位 目录类操作(lookup/create/remove/rename)的互斥现在由父目录 inode 的 i_rwsem 承担,且锁顺序是 i_rwsem 在 d_alloc_parallel() 之上——查 / 建目录项都得先拿父目录这把读写锁。
做法 Neil Brown 的长期目标是让 VFS 锁 dentry 本身、把父目录 i_rwsem 下沉到各文件系统自己取舍。要换顺序先做两件事:一是不在持有 i_rwsem 时调 d_alloc_parallel()(引入 d_alloc_trylock()、加 LOOKUP_SHARED 让调用方知道锁是共享还是独占);二是别在 dentry 被操作途中 d_drop() 它——增强 d_splice_alias() 以接纳 hashed dentry,好让 d_add() 退役。这 6 帖是 VFS 核心侧铺路,后续还带 7 nfs + 6 afs + 4 smb + 3 cephfs 各文件系统补丁。
效益或下一步 方向打通后,各文件系统可按自身并发模型取舍父目录锁(保留 / 去掉 / 换更细粒度),为目录级并发打开空间。v3 在评审,铺垫与 FS 侧补丁希望同窗口落地。
和你相关 做 VFS 并发或写文件系统(尤其 nfs / afs / smb / ceph 读者)的,这套锁顺序重构是未来几年目录性能的天花板所在。
🔗 原文
📰 mm
/ column ★ 给 pmem 省掉 struct page:轻量沙箱 VM 起得更快、塞得更密
〔09-03 20:21 北京〕· [PATCH 0/4] mm: Reduce struct page overhead for FS-DAX pmem
定位 用 virtio-pmem + FS-DAX 给轻量沙箱 VM 做文件系统,能省掉客户机页缓存这第二份数据副本;但客户机要为整个 pmem 口径注册 ZONE_DEVICE,并给每个物理页分配、初始化 struct page——vmemmap 约占设备大小 1.56%,这批初始化还会拖慢起机。
做法 4 帖(字节跳动 Song Muchun)的关键观察:sizeof(struct page) 是 2 的幂时,每个 PAGE_SIZE 的 vmemmap 页里是一组天然对齐、可重复的 struct page 槽位——只走 DAX 直读直写、或根本没被访问的区间,并不需要各自独立的可写 per-PFN 私有态;据此把这类范围的元数据摊薄复用,减少登记时的分配与初始化。
效益或下一步 稀疏根盘镜像的洞、纯 read/write 访问的 DAX 块都不再白付逐 PFN 的私有元数据成本——沙箱 VM 更省内存、起机更快,宿主侧高密度 / 高 overcommit 更稳。评审继续。
和你相关 做无服务器沙箱、云上轻量 VM 密度优化、或用 DAX/pmem 当根盘的,这条直接关系「每台 VM 多背多少内存开销」。
🔗 原文
📰 net
/ column ★ vxlan 配置全体搬进 RCU:转储 vxlan 不再死等 RTNL
〔09-03 20:08 北京〕· [PATCH net-next 0/9] vxlan: convert configuration to RCU and drop RTNL in vxlan_fill_info()
定位 内核里几乎所有 netlink 转储(如 ip -d link 看 vxlan)都要先拿 RTNL 这把全局大锁串行;vxlan 的配置(struct vxlan_config)此前直接嵌在设备结构里由 RTNL 保护,fill_info() 也只在持锁下读——全局锁是 dump 并发与延时的天花板。
做法 9 帖(Google Eric Dumazet)把 vxlan->cfg 变成 RCU 保护的动态指针:先修审计中发现的三个既有问题(元数据选项缺失时栈上 _md 未清零、可能把未初始化字节带进 GBP 头;vnigroup 同步释放的 use-after-free;vnifilter dump 缺 RCU 迭代),再把配置发布 / 释放迁到 rcu_assign_pointer() 与 kfree_rcu()、读侧统一进 rcu_read_lock(),VXLAN_F_MDB 这类运行态标志从 cfg 挪进原子位,最后让 vxlan_fill_info() 不再依赖 RTNL——实现无锁转储 vxlan。
效益或下一步 转储 vxlan 接口不再排队等 RTNL,配合各设备的同类改造,全局锁在 netlink dump 路径上一步步退场;顺带修掉三个真实并发 bug。
和你相关 做隧道网关、大规模 vxlan 部署、或关注内核「去 RTNL 化」主线的,这是又一块拼图。
🔗 原文
📰 DRM
/ column ★ 把 bridge 直接长进 panel:DRM 想把两套抽象合成一套
〔09-03 16:11 北京〕· [PATCH RFC v2 00/19] drm/panel: embed a drm_bridge into every drm_panel
定位 DRM 显示链路上有两类接线元件:panel(显示屏本体)与 bridge(信号转换 / 串接芯片),各自独立分配、独立生命周期。要让某个驱动把下游当 bridge 用,就得由别的驱动临时 drm_panel_bridge_add() 包一层——面板自己的驱动反而管不到这个包装何时建、何时拆、要不要拆。
做法 19 帖(Bootlin Luca Ceresoli)换思路:直接把一个 drm_bridge 嵌进每个 drm_panel 结构里——panel 驱动创建面板时 bridge 就绪、行为与现在的 panel_bridge 一致。做法是把 bridge/panel.c 里的实现搬进 drm_panel.c、改成更贴切的函数名,并让 analogix_dp 等引用驱动不再自己建临时 panel_bridge。
为什么 现在动手的原因:bridge 热插拔与「动态 bridge 生命周期」即将落地,靠 devm / drmm 延迟回收临时 panel_bridge 的旧做法会撑不住;让 bridge 随物理设备(面板)的驱动创建,所有权与回收路径都清晰。
效益或下一步 显示驱动的接线逻辑收拢为统一的 bridge API,逐驱动少一道「这个 bridge 是不是我建的 panel_bridge」判断题。RFC v2 已收到多方反馈,主要争议预计在面板驱动适配量与应用节奏。
和你相关 写 panel / bridge / 显示控制器的,这套「panel 内嵌 bridge」会重塑接线模型——早看懂早省事。
🔗 原文
📰 PCI
/ column ★ PCIe endpoint 借 vNTB 打通远端 DMA:主机直接读走设备端内存
〔09-03 16:25 北京〕· [PATCH v4 0/7] PCI: endpoint: Remote DMA support via vNTB
定位 vNTB(虚拟非透明桥)让 PCIe endpoint 与 root complex 之间形成一条桥接的对等链路、两端可互通。想让 RC 侧能对 endpoint 本地内存发起 DMA 读,以往常要专门定义一套远程 DMA 通道或 ABI。
做法 7 帖(Koichiro Den)让 RC 借 endpoint 侧 DesignWare eDMA 的读通道走 vNTB 读数据:pci-epf-vntb 把整条 eDMA 读方向预留出来、以通道组形式暴露;不新造通用 remote-DMA ABI,导出收在 pci-epf-vntb 与 ntb_hw_epf 两驱动内部。新增 dma_bar 的 configfs 属性做开关(默认 -1 即关闭,pci-epf-ntb 不受影响);此版仅支持 unrolled DW eDMA,基于 v7.3-rc1。
效益或下一步 为基于 PCIe endpoint 的 NTB / 共享内存 / 加速器场景铺一条不触碰通用 DMA 框架的读写捷径;v4 已带此前评审修出的问题。非 unrolled eDMA 形态留待后续。
和你相关 做 PCIe endpoint / NTB / SmartNIC 内存共享的,这条演示了「不新造 ABI、把能力收口在驱动内」的克制改法。
🔗 原文
📰 media
/ column ★ ams OSRAM Mira016 传感器终于有了 Linux 驱动
〔09-03 20:16 北京〕· [PATCH 0/2] media: i2c: Add driver for Mira016
定位 Mira016 是 ams OSRAM 的一颗图像传感器,此前内核没有对应驱动,设备厂商想接就得自己写或压根接不上。
做法 2 帖(Ideas on Board Jacopo Mondi)新增 mira016.c——2284 行驱动 + 配套 dt-bindings,走标准 v4l2-subdev 接口;对应 MAINTAINERS 同步登记。
效益或下一步 板卡可直接用这颗传感器出图,省去自己维护闭源补丁;新驱动按惯例进 drivers/media/i2c 收审。v1 是首发,评审收集期。
和你相关 做嵌入式视觉 / 相机板卡的,多一颗有主线驱动的传感器就少一个供应商绑定。
🔗 原文
📊 板块活跃度 · 近 24h
/ column 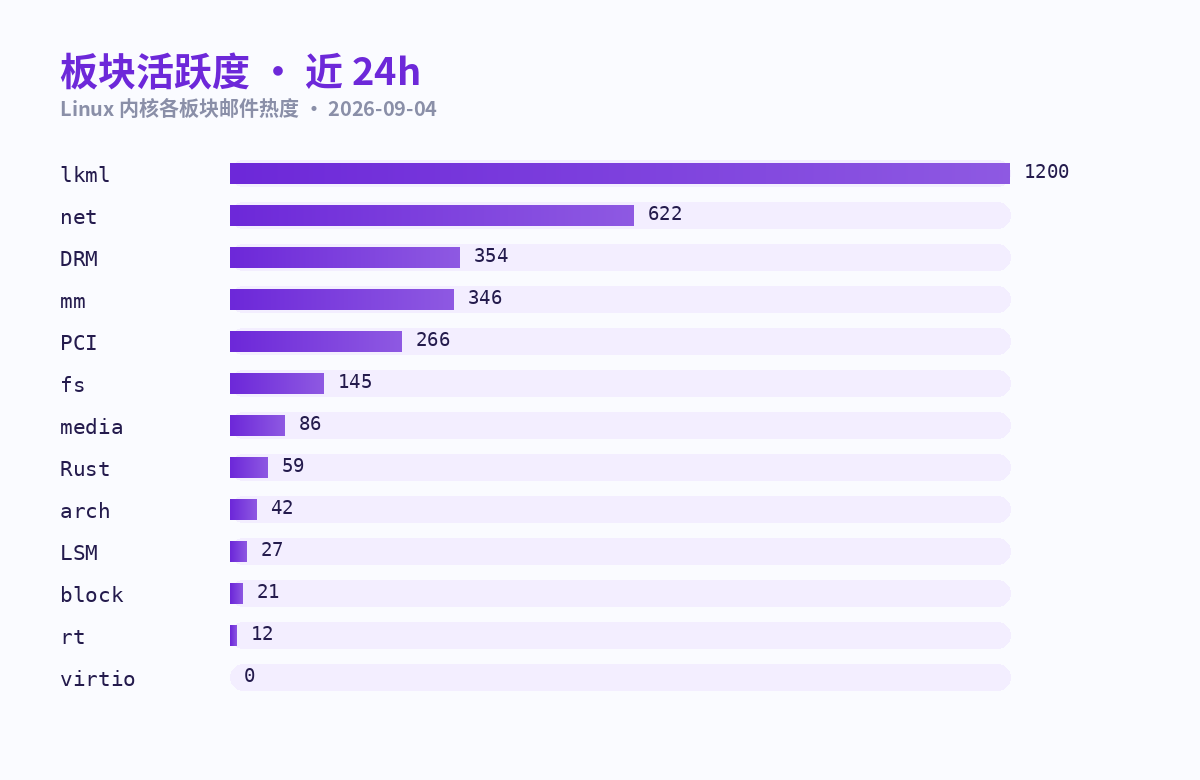
Top3 lkml 1200 · net 622 · DRM 354(radar.sh stats 全 13 列表 T24 计数)
观察 net 稳居非广播源第一(622)——v7.3 rc 阶段 pull / fix 密集;DRM(354)与 mm(346)咬得很紧,fs(145)被 ext4 31 帖撑起;PCI(266)· media(86)· Rust(59)正常水位;virtio-dev 近 24h 0 条,板块今日暂无强主题。
⚙️ 机制雷达:6 条跨域改动
/ section exec/arch 从 UAPI 移除 AT_VECTOR_SIZE_ARCH(v2·00/15,linutronix)——架构私有 aux 向量长度宏收归内核,不再外泄给用户态 ABI 原文 mm/dma 别再用 GFP_DMA 调 dma_alloc_coherent(00/13)——清理历史遗留的 GFP_DMA 滥用,一致性 DMA 内存分配归位 原文 x86 MCE 定时器链表损坏修复 + 避免冗余轮询(v5·0/3,atomlin)——机器检查定时器路径的链表与唤醒整理 原文 driver-core Faraday FOTG210 USB 驱动现代化(v3·0/6)——老 gadget 控制器驱动按新 bus / API 重构 原文 efi/arch libstub 靠优化 GUID 存储瘦身(0/3)——EFI 启动存根压缩 128 位 GUID 的存放方式以降体积 原文 Rust rust: const_eval 支持 const 内调用 trait 的机制(v2·0/3,Gary Guo)——为内核 Rust 在编译期走 trait 方法铺路 原文
📖 本期概念速查
/ section iomap 现代文件 I/O 框架——把「文件区间 ↔ 磁盘块」统一成 iomap 描述,读写 / 回写都走它;xfs / btrfs 已在用,今日 ext4 buffered 路径迁入。
buffer_head 老的块缓冲记账结构——每块一个 buffer_head,ext4 buffered I/O 的旧引擎,正被 iomap 逐步取代。
folio 页缓存的新计量单位:可含多个 page 的复合页(常见 64K / 2M)。大 folio 提吞吐,也带来「一脏俱脏」的粒度问题。
脏位 / 回写 文件页写入后先留在页缓存、由内核统一回写磁盘;是否该写回由脏标志记录。粒度越粗,无效回写越多——今日头条之二的主角。
ZONE_DEVICE / vmemmap 为特殊内存(pmem、设备内存)建立「每物理页一份 struct page」的元数据机制;vmemmap 是其虚拟布局。今日讨论能否摊薄(FS-DAX)。
vNTB 虚拟非透明桥——把 PCIe endpoint 与 root complex 桥接成对等链路,供 NTB 语义的 DMA / 共享内存使用;今日 PCI 头条的主角。
RTNL 内核网络全局大锁(rtnl_mutex),几乎所有 netlink 配置 / 转储先拿它。「去 RTNL 化」是把读路径迁到 RCU、缩小全局串行范围。
如果对你有用,点个赞,或留言聊聊你最关心的内核话题。
数据来源:lore.kernel.org(全内核 13 列表)· 北京时间
💬 评论
使用 GitHub 账号登录即可留言