今天的 dri-devel 上演了一出「AI 审 AI」:一个账号在三个多小时里连发 69 封引用计数修复补丁, 而列表上的 AI 评审机器人,在其中一封里当场抓出一处 type confusion—— 这个「修复」本身会把虚表指针减一。另一头,DRM 显示管线里 panel 与 bridge 的寿命错位,终于要用 19 帖抹平。
🎬 今日导读
/ section 头条 69 封引用计数补丁里藏着一个陷阱:AI 评审把它指出来了
头条 panel 和 bridge 的寿命错位,要用 19 帖抹平(v3)
media v4l2_m2m 第一次支持并行 job,RGA 借它吃满多核(v2·17 帖)
media V4L2 缓冲区终于能查到「是谁申请的」(4 帖 + v4l2top)
mm 截断大页时的数据丢失(v3·3),为 ext4+iomap 提前排雷
mm 每个 page_counter 自己攒 per-CPU 库存(v6·5)
DRM reset 钩子从 plane 上退场,51 个驱动改 atomic_create_state
net *_fill_info() 集体去 RTNL:vlan、hsr、rmnet 一夜之间
机制 SEV-TIO 的 PCIe TDISP 第二阶段、blk-iocost 的 BPF struct_ops
📊 板块活跃度
/ column 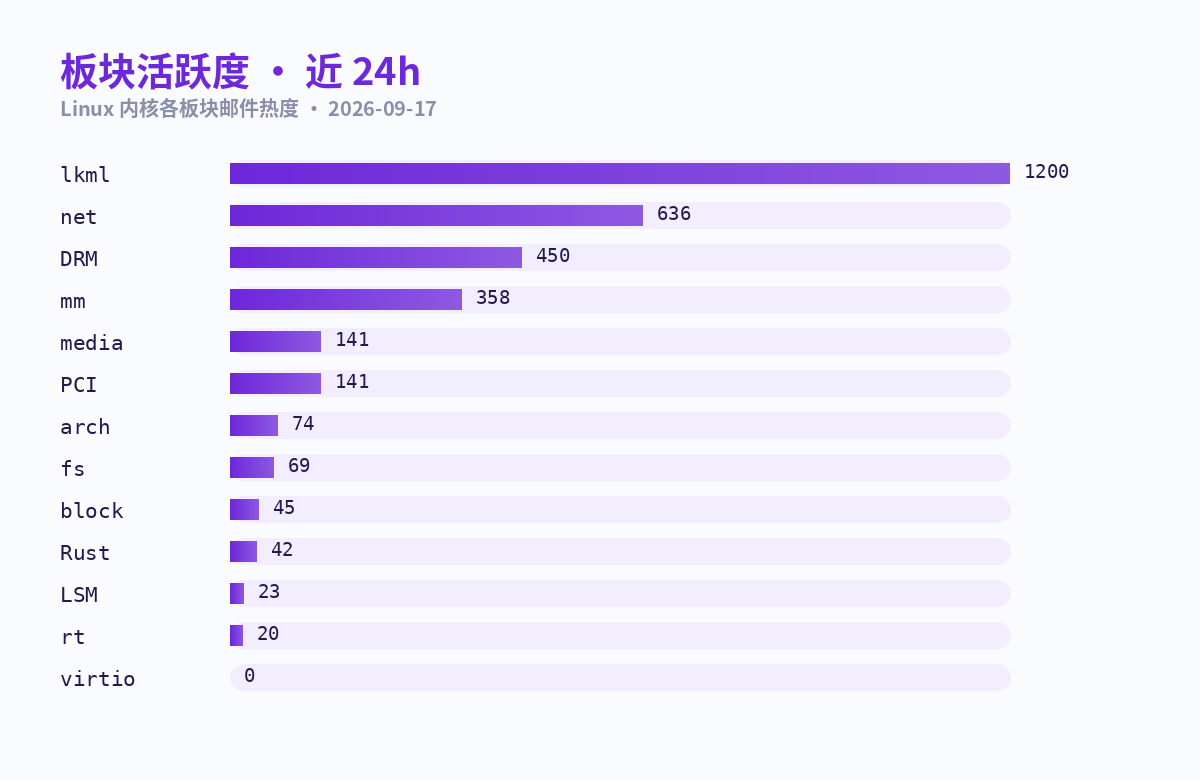
近 24h 各板块真实计数:lkml 1200(全内核广播源,已限流)· net 636 · DRM 450 · mm 358 · media 141 · PCI 141 · arch 74 · fs 69 · block 45 · Rust 42 · LSM 23 · rt 20 · virtio 0(低频列表,本窗口无新帖)。今天 net 与 DRM 两个板块的量,一大半来自批量提交。
💡 今日头条
/ section 69 封引用计数补丁里藏着一个陷阱,AI 评审把它指出来了
〔09-16 23:40 ~ 09-17 02:31 北京〕· [PATCH] drm/*: Fix … reference leak(dri-devel,共 69 封)
现状 内核里对象的引用计数(kref / refcount_t)靠「拿到就 put」的约定维持:漏一次 put 就是内存泄漏, 多一次 put 就是 use-after-free。这类错误编译器看不见,只能靠人读代码,或者靠工具扫。
痛点 DRM 子系统驱动多、错误路径长,漏 put 的点位散落在几十个驱动里,人肉审计根本扫不过来。 这块空白正是自动化扫描想填的位置。
方案 9-16 深夜(北京时间 23:40 起)到次日凌晨,署名 Wentao Liang、信箱落在 iscas.ac.cn 域下 vulab 的账号,向 dri-devel 连发 69 封补丁,标题高度统一:「Fix 〈某对象〉 reference leak / use-after-free in 〈函数〉()」。覆盖面包括 i915(9 封)、bridge(8)、 amdgpu(6)、rockchip(4)、meson(4)、nouveau、msm、vmwgfx 等。
为什么 其中一封修 tegra 的,问题本身是真的:host1x_reloc_copy_from_user() 在 cmdbuf 查到、 target 查不到时直接 return -ENOENT,漏掉了 cmdbuf 那一份引用。但补丁给出的修法是 drm_gem_object_put(dest->cmdbuf.bo)——而 cmdbuf.bo 是 struct host1x_bo *, drm_gem_object_put() 要的是 struct drm_gem_object *。两者布局不同:host1x_bo 的第一个成员 是 ops 虚表指针,drm_gem_object 的第一个成员是 kref(一个 4 字节的 refcount_t)。 这次 put 会把虚表指针的低 32 位减一。路径还能从用户态经 DRM_IOCTL_TEGRA_SUBMIT 走到, 于是「修内存泄漏」变成了「毁虚表指针」。
效益 内核的审查机器人 Sashiko(sashiko-bot@kernel.org)在 55 分钟后回了这封补丁, 判定 [High]。我对照 7.3-rc3 的源码逐项核过:struct host1x_bo 的首成员确实是 const struct host1x_bo_ops *ops,struct drm_gem_object 的首成员确实是 struct kref, 判断成立。这个驱动的正确释放方式是 host1x_bo_put(),或者先 host1x_to_tegra_bo() 转成 tegra_bo 再取 &obj->gem——它自己的 fail 路径就是这么写的。
下一步 同一天,Sashiko 在 dri-devel 上发出 56 条评审,其中 29 条至少报出一个 High 级问题。 人类维护者目前没人接话。这件事的看点不在某一封补丁对错,而在两条自动化流水线第一次正面撞上: 一边批量生产修复,一边批量审查修复——审查这一侧,今天接住了。
一句话点评 补丁值不值得收最终还得人来看。但今天这条线程说明:批量生成的修复,正在被批量生成的审查挡一道。
🔗 原文
panel 和 bridge 的寿命错位,要用 19 帖抹平
〔09-16 21:45 北京〕· [PATCH v3 00/19] drm/panel: embed a drm_bridge into every drm_panel(Bootlin · Luca Ceresoli)
现状 DRM 显示管线里,数据从 encoder 出发,经过一级级 drm_bridge,最后到达 drm_panel (真正那块屏)。但 panel 自己并不是一个 bridge——它被创建出来之后,通常还要由访问它的 那一级(一般是前一个 bridge 或 encoder)再包一个 panel_bridge 出来。
痛点 包出来的 bridge 和被包的 panel,是两份各自独立的生命周期与 devm 归属。谁先释放谁后释放, 全靠约定维持。一旦要支持「热插拔一块屏」,这个错位就几乎没法处理。
方案 v3 系列把 drm_bridge 直接内嵌进每一个 drm_panel:分配时(devm_drm_panel_alloc()) 就带出一个已经初始化好的 bridge。老的 panel_bridge API 保留不删,但语义换掉了—— drm_panel_bridge_add() 不再创建 bridge,只是 drm_bridge_get() 后返回已有的那个; remove 对应地只是 put。
为什么 这是典型的「不让调用方改一行」的迁移:老驱动行为自动变成新的,系列随后再把 tc358767、samsung-dsim、analogix_dp、omap dss、tve200、fsl-ldb 等 10 个驱动 改成不再自建 panel_bridge,并在 drm/todo 里登记「最终删掉 panel_bridge API」。
效益 panel 和 bridge 从此是同一个对象的两种视角,生命周期与 devm 归属合一, 桥热插拔才有实现的地基。写显示驱动的同学,这是接下来一两年要适应的接口变化。
下一步 系列依赖另一组 DRM_PANEL Kconfig 清理(两者都动 bridge/Kconfig,作者索性声明了依赖)。 v3 只是把抽象摆好,后续逐个驱动迁移会持续一段时间。
一句话点评 19 帖、v3、Bootlin 推——「先把抽象摆正、再慢慢搬驱动」,这是 DRM 里少数能把树级重构做成的路子。
🔗 原文
📰 media 视频采集
/ column ★ ★ v4l2_m2m 第一次支持并行 job,RGA 借它吃满多核
〔09-16 23:09〕· [PATCH v2 00/17] media: rockchip: rga: Add multi-core support(Pengutronix · Sven Püschel)
定位 v4l2_m2m(memory-to-memory)是 V4L2 给编解码器与图像处理器用的任务队列框架,瑞芯微的 RGA(2D 图形加速器:缩放、旋转、色彩转换)就建在它上面。框架原本一次只把队首一个 job 发给驱动——因为 v4l2_m2m_dev 里存着一个 curr_ctx。
做法 这个系列给框架加了 max_parallel_jobs 与 v4l2_m2m_set_max_parallel_jobs(), 驱动把并行度设成自己的核数,框架于是把队首 N 个 job 一起发给 device_run; curr_ctx 随之删掉。同时用 component 框架把所有 RGA 核挂到同一个实例上—— 此前探测到第二个相同核时会直接 -ENODEV 丢掉。
效益或下一步 目标机型 RK3588 有一个 RGA2-Enhance 加两个 RGA3。调度只做在 context 级, 所以单路视频流不会变快——要榨出多核得跑至少 N 路并行流。作者明说这是为了绕开 「核之间有速度差会导致帧序错乱」的复杂缓冲处理。
和你相关 写 v4l2 m2m 驱动的话,max_parallel_jobs 是这次真正值得记的接口;多核编解码那边(rkvdec)走的是另一条路,作者在封面信里顺带点评了。
🔗 原文
★ ★ V4L2 缓冲区终于能查到「是谁申请的」
〔09-16 22:25〕· [PATCH 0/4] media: Track v4l2 buffers through an allocator(Collabora · Detlev Casanova)
定位 V4L2 的缓冲区由内核分配,但用户态想知道「这是哪个进程、哪个 fd、为哪个驱动申请的」, 只能去翻 /sys/kernel/debug/dma_buf/bufinfo——那是 DMA-BUF 的通用信息, 和具体驱动、申请方对不上号。多个驱动同时在跑的时候尤其难查。
做法 系列(4 帖)给 DMA-BUF 分配加了一层包装,把记录挂在 video device 上,附带名称、 申请进程的 pid 与 fd,再通过 debugfs 暴露;verisilicon 与 rkvdec 两个驱动已接过去。 另一条 RFC(3 帖)在做配套的 v4l2top 工具。
效益或下一步 调试从「猜这块 buffer 是谁的」变成 cat 一个文件就有 pid / fd / size / label 表。 系列依赖一个给 v4l2_fh 补 fd/pid 的 ftrace 补丁系列,作者自己说那个系列有点旧, 所以最后两个提交基于较老内核。
和你相关 写 v4l2 驱动、或要给用户态做内存计量的话,这是条早期但方向明确的线——V4L2 的可观测性一直比 DRM 差一截。
🔗 原文
📰 mm 内存管理
/ column ★ ★ 截断大页时的数据丢失(v3),为 ext4 + iomap 提前排雷
〔09-16 17:32〕· [PATCH v3 0/3] mm/truncate: fix data loss when truncating straddling large folios(华为 · Zhang Yi)
定位 mm/truncate.c 的截断路径。当一个「横跨截断边界」的大 folio 需要被切开时 (straddling large folio),切分本身可能失败——这层要处理的就是失败之后的数据怎么处置。
做法 补丁 1 给 truncate_inode_partial_folio() 补上 pstart / pend 两个参数, 修掉「第二次切分失败」时的数据丢失;补丁 2 把截断边界对齐到文件系统的最小 folio order, 让 min_order > 0 的文件系统不踩同一个坑;补丁 3 收拾那个含义混乱的返回值。
效益或下一步 问题是在 ext4 + iomap buffered I/O 转换过程中被抓出来的——也就是说, 这是「为一个还没合入的改动提前排雷」。v3 已被 Zi Yan、Brian Foster、Jan Kara 评过一轮, v2 里 sashiko 指出的并发问题也在 v3 处理掉了。
和你相关 改文件系统、或者碰 iomap 的同学,这条是必须跟的相邻改动——数据丢失级别的 bug,且修法还在收敛。
🔗 原文
★ ★ 每个 page_counter 自己攒 per-CPU 库存
〔09-17 05:06〕· [PATCH v6 0/5] mm/page_counter: move stock from mem_cgroup to page_counter(Joshua Hahn)
定位 memcg 给每个 CPU 留了一份「预充电」页库存(per-CPU stock),让小额度分配不必每次都 沿着 memcg 层级走一遍。但这份库存的实现写在 memcontrol 里,尽管它缓存的其实是 page_counter 的 charge 操作。
做法 v6 把 stock 从 mem_cgroup 搬到 page_counter,让每个 page_counter 自带 per-CPU 缓存。 相比 v5,v6 砍掉了「改分配与排空行为」的部分,只保留搬移——收到反馈后主动缩范围。
效益或下一步 对 memcg v2 用户无功能变化;对 v1 用户,memsw 与 memory 的 stock 解耦,各自维护独立预充缓存。 真正的目的是作者自己的 tiered memcg limits 系列:那会给 memcg 加好几个新 page_counter, 不先搬这一层,每次 charge 都要多走几遍层级。
和你相关 要往 memcg 里加新计量维度的同学,这条是在给你铺路——先让 stock 变成 page_counter 自己的事。
🔗 原文
📰 DRM 显示与图形
/ column ★ ★ reset 钩子从 plane 上退场,51 个驱动改 atomic_create_state
〔09-16 16:55〕· [PATCH v5 0/9] drm/plane: Convert all drivers to atomic_create_state and remove reset(Maxime Ripard)
定位 KMS 的 reset 钩子身兼两职:probe 时创建初始软件状态,suspend/resume 时重置软硬件状态。 这两个角色的要求不一样,而且 reset 不可失败,导致初始状态分配路径的错误处理很难写。
做法 引入 atomic_create_state:只负责分配并初始化一份干净状态、没有副作用,成功返回状态指针, 失败返回 ERR_PTR。系列先补齐 simple-kms 与 GEM 原子 helper 的基础设施, 再用 Coccinelle 语义补丁加手工调整,把树内全部 51 个 plane 驱动迁过去, 最后把 reset 钩子本身从 struct drm_plane_funcs 里删掉。
效益或下一步 这接在 bridge 去 reset 系列之后,是「把所有 KMS 对象的 reset 钩子删干净」这个更大目标的一环。 树级接口能在一次系列里收口,靠的是辅助库先铺垫、再让语义补丁批量搬驱动。
和你相关 写 DRM 驱动的同学:plane 驱动的 probe 路径接下来要按 atomic_create_state 写,reset 会消失。
🔗 原文
📰 net 网络
/ column ★ ★ *_fill_info() 集体去 RTNL:vlan、hsr、rmnet 一夜之间
〔09-16 21:22 ~ 21:28〕· [PATCH net-next 0/*] vlan / hsr / rmnet: lockless *_fill_info()(Eric Dumazet)
定位 netdev 的 dump 路径(*_fill_info)传统上要拿 RTNL 大锁,因为要遍历设备列表、 读各种运行状态。RTNL 是全局锁——dump 一慢,整条网络配置路径都得排队。
做法 9-16 晚上,Eric Dumazet 连发三组小系列:vlan(2 帖)、hsr(2 帖)、rmnet(3 帖), 把各自的 *_fill_info() 改成 lockless——读侧改用 RCU 保护、去掉 RTNL, 写侧补上相应的同步。这之前 netkit(不去 RTNL)与 vxlan vnifilter(收敛每 VNI 记账) 也走的是同一套路。
效益或下一步 ip -s link、ethtool -S 这类 dump 不再抢全局锁,配置路径的尾延迟跟着下来。 看得出是在按协议逐个收口,剩下没搬的协议大概会陆续跟上。
和你相关 如果你在写 netdev 的 ndo_fill_info 或 dump 回调,这就是社区当下的既定方向:能不拿 RTNL 就别拿。
🔗 原文
📰 PCI 总线
/ column ★ ★ CXL Type-2 设备透传:vfio/pci 的 27 帖
〔09-17 02:36〕· [PATCH v5 00/27] vfio/pci: Add CXL Type-2 device passthrough support(NVIDIA · mhonap)
定位 vfio/pci 负责把物理 PCI 设备交给虚拟机直接使用。CXL Type-2 设备是「带设备内存的加速器」 (GPU、FPGA 一类),它的内存既属于设备、又能被 CPU 访问——比普通 PCI 设备多出一层 内存归属问题,此前不在透传支持范围内。
做法 v5 系列(27 帖)给 vfio/pci 补上 CXL Type-2 的透传支持。系列体量大、跨 vfio 与 CXL 两侧, 版本号走到 v5 说明设计已经过多轮讨论。
效益或下一步 虚拟机里能直接驱动带设备内存的加速器,不必再依赖厂商私有的透传方案。 对做异构计算与虚拟化的同学,这是把 CXL 设备真正用起来的前提之一。
和你相关 涉及 vfio 透传、CXL 或 GPU 直通的项目,值得盯这个系列的评审意见——它会界定「设备内存」在虚拟机边界上怎么算。
🔗 原文
📌 机制雷达:6 条跨域大改动
/ section SEV-TIO / PCIe TDISP(phase2) RFC·17 帖,AMD 把 SEV-SNP 的可信执行扩到 PCIe 设备(TDISP 是 PCIe 的 TEE 设备接口标准),一次动 PCI、机密计算与 mm 三块 · 原文 blk-iocost 的 BPF struct_ops 成本模型 RFC v4,把 IO 成本模型做成 BPF struct_ops,可以运行时替换而不用改内核 · 原文 strlcat() 树级退场 28 帖,把内核里剩下的 strlcat() 调用点统一换成 snprintf() / seq_buf(),去掉这个易错接口 · 原文 dyndbg classmaps API 修复 v10·38 帖,动态调试的 classmap 接口跨子系统收口,附带查询扩展与自测 · 原文 hfs:构造镜像触发 may_open() 里的 BUG 一个无类型的内部 B-tree inode 被别名进 VFS open 路径,直接撞内核 BUG——老文件系统的输入校验缺口 · 原文 rust: mem 新增 DropGuard 一天内连发四版,给内存操作加 RAII 守卫,让「必须成对」的操作靠类型系统兜住 · 原文
📖 本期概念速查
/ section kref / refcount_t 内核的引用计数原语。kref 包一层 refcount_t,对象最后一个引用释放时自动调用析构函数——漏一次减一就泄漏,多一次减一就 use-after-free。
type confusion 类型混淆:把 A 类型的指针当成 B 类型用。两者内存布局一旦不同,读写就会落在错误的字段上——本期是把 host1x_bo 当 drm_gem_object 使。
drm_panel / drm_bridge 显示管线上的两类对象:bridge 是「一段转换」(MIPI 转 eDP 之类),panel 是「那块屏」。本期要让每个 panel 自带一个 bridge。
panel_bridge 过去为了让 panel 能接进 bridge 链条,由访问方临时包出来的适配对象。它与被包的 panel 寿命不一致,是本期 19 帖要解决的问题。
straddling large folio 横跨截断边界的大页。截断时它必须被切开,而切分可能失败——本期 mm 的数据丢失 bug 就出在失败路径上。
per-CPU stock memcg 给每个 CPU 预充的一小份页库存,让小额度分配不必每次都沿 memcg 层级走一遍。本期它正从 mem_cgroup 搬到 page_counter。
RTNL 网络子系统的全局配置锁。dump 设备信息时拿它会阻塞整条配置路径——本期一批 *_fill_info() 正把它换成 RCU 读侧保护。
v4l2_m2m V4L2 的 memory-to-memory 任务队列框架,编解码器与图像处理器建在它上面。本期它第一次支持一次派发多个并行 job。
如果对你有用,点个赞,或留言聊聊你最关心的板块。
数据来源:lore.kernel.org(全内核 13 列表)· 数据截至 09-17 06:50 北京 · 时区均为北京时间
💬 评论
使用 GitHub 账号登录即可留言