今天 Linux 内核圈,值得花 3 分钟看两件事:VFS 对「负目录项」动手了(Neil Brown 18 篇治软锁死),和 BPF 程序可以自己发 UDP 了(bpf_ksock 合入 bpf-next)。
🎬 今日导读
/ section 头条 VFS 18 篇治 negative dentry:refcount 溢出 + 目录遍历软锁死
头条 bpf_ksock 合入 bpf-next:BPF 程序自己建 UDP socket 发遥测
mm page_alloc 分家 unmapped 空闲类型,MGLRU 加频率引导
机制 x86 补 vzeroupper、futex/pi 堵 exec 竞态、driver core 加 reprobe
💡 今日头条
/ section VFS 治 negative dentry:18 篇先摁住 refcount 溢出和目录遍历软锁死
〔08-15 12:28 北京〕· [PATCH RFC/RFT v2 00/18] Fix easy bits of the negative dentry problem
现状 路径查找失败时,内核会缓存一个「负目录项」(negative dentry,记录某路径不存在)来加速下一次重复查找。正常时它很有用,但海量堆积时有两个已知症状:父目录的引用计数可能被数十亿个负子项顶到溢出;遍历某个目录的子项链表(->d_children)可能耗时任意长、直接触发软锁死。
痛点 这两个症状是真实可触发的——有用户在特定目录布局下遇到 soft lockup,refcount 溢出则是一颗潜在的计数器炸弹。内核社区对「负目录项问题」讨论已久(LWN 有专文),难点不少。
方案 Neil Brown 的 v2 共 18 篇,只挑「easy bits」治。核心:给所有遍历 ->d_children 的代码做一个公共 helper,教它学会「drop 锁 + 按需调度」,并用一个游标(cursor)记住位置继续走,从而把长时间持锁变成可抢占的短持锁。配套:第 1 篇不再通过 ->d_parent 计引用(消除溢出源);libfs 的 readdir 扫目录代码大重构;fsnotify 不再跨 spin_lock 调 recalc_mask、收窄 i_lock 持有时长;autofs / coda / nfs 统一换新迭代器。最后 3 篇来自 Miklos Szeredi 的 review 建议。
为什么 刻意不碰「负目录项数量本身」——那是难啃的骨头。作者明确留了两个尾巴:目录遍历「任意长」的根本问题先不解决,d_walk() 也留到后续系列。先把最危险的两个具体症状(溢出 + 软锁死)摁住,每颗钉子都小、好审。
效益 目录级 soft lockup 消除:任何进程持锁扫目录时不再卡死整机;refcount 溢出风险清零。libfs 的扫目录逻辑也顺手被统一成一条路径,后续再治「任意长」时地基已铺好。
下一步 RFT = 请求测试:作者在找能触发负目录项堆积 / 软锁死的用户帮忙验证;后续系列再啃 d_walk() 和遍历「任意长」的部分。
一句话点评 先治标的两步,把最危险的两个症状摁住了——VFS 地基又稳了一点
🔗 原文
bpf_ksock 合入 bpf-next:BPF 程序第一次能自己发 UDP
〔08-16 05:40 北京〕· [PATCH bpf-next v7 0/5] Introduce bpf_ksock(已合入 bpf-next)
现状 内核里的 BPF 程序(尤其是 LSM / 安全监控类)想对外发一条数据,过去必须借助用户态 agent / daemon:BPF 把事件写进 ringbuffer 或 map,用户态进程取出来再通过网络发出。
痛点 完全依赖用户态进程 = 单点依赖:agent 一旦宕机,安全告警 / 遥测就断流。Isovalent 的 Tetragon 就因此想让安全事件能绕开 agent 直发;Meta 则想用它替代跨二进制版本容易失配的 ringbuffer 日志方案。
方案 v7 5 篇引入 bpf_ksock——一组新的 BPF kfunc,让 BPF 程序自己创建 UDP socket 并发数据。具体:net 层加一个 connect_socket() helper,bpf 层加 ksock kfuncs,附全套 selftests。Daniel Borkmann 已把它合入 bpf/bpf-next。
为什么 选「让 BPF 直接开标准 UDP socket」而不是发明新的内核出网通道,是复用现成网络栈、改动面最小的做法;UDP 无连接、开销低,够遥测场景用。
效益 BPF LSM 程序可以完全独立于用户态发安全告警 / 遥测——agent 掉线也能报警;Tetragon 构想「开机后不再需要常驻 agent」;Meta 可替换 ringbuffer 日志,消除二进制版本耦合。
下一步 已进 bpf-next,7.3 合入主线可期;当前支持 UDP socket 的创建与发送,后续大概率扩展更多 socket 能力与协议。
一句话点评 BPF 第一次有了「自己的嘴」——不经过用户态也能对外说话
🔗 原文
📊 板块活跃度
/ column 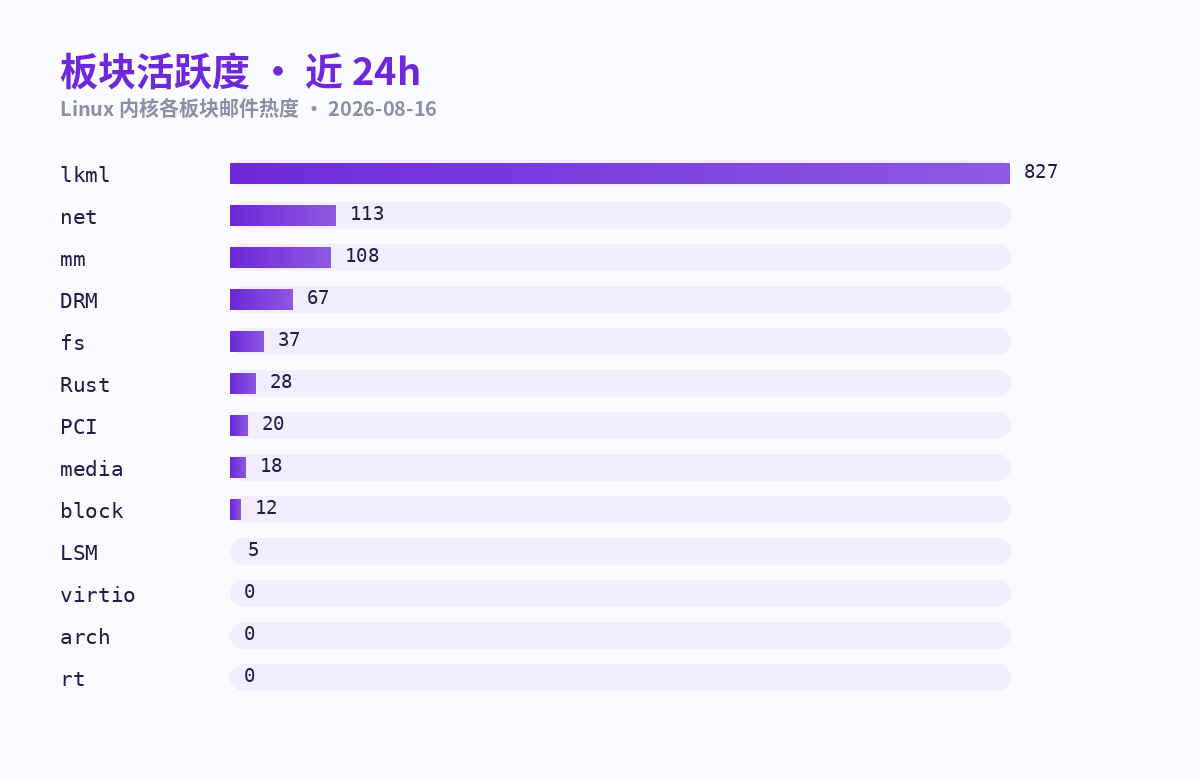
近 24h 各板块热度(13 列表统一 T24 计数):lkml 827 · net 113 · mm 108 · DRM 67 · fs 37 领跑;Rust 28 · PCI 20 · media 18 · block 12 · LSM 5 中位;rt / virtio / arch 近 24h 静默,留待月报盘点。
📰 fs
/ column ★ btrfs 放开 idmapped 挂载下的 DEFRAG
〔08-15 21:23 北京〕· fs · PATCH v2
定位 btrfs + idmapped 挂载(容器 / 用户命名空间常用):被映射命名空间里的进程此前调 DEFRAG ioctl 会被拒绝。
做法 v2 允许 idmapped 下的 DEFRAG ioctl,权限检查走 mnt_idmap 把调用者身份正确映射回超级块 inode。
效益 容器 / 用户命名空间里可以正常对 btrfs 碎片整理,行为与宿主一致。
和你相关 跑容器化 btrfs 存储的同学可关注。
🔗 原文
📰 mm
/ column ★ page_alloc 给「不映射的页」分了家:FREETYPE_UNMAPPED(v3,26 篇)
〔08-15 22:12 北京〕· mm · PATCH v3 00/26
定位 mm/page_alloc 分配层:内核物理页按是否会被映射到用户态,应走不同的分配 / 回收行为,但当前没有显式区分。
做法 Vlastimil Babka 的 26 篇 v3:引入 FREETYPE_UNMAPPED 分配类型,unmapped 分配走专属路径;必要时把某个 pageblock 整体转换成 unmapped 类型(改 direct map),并为 unmapped 分配始终尝试直接压缩(direct compact)。讨论中 Yosry / Brendan 在核对 pcplist 补货与 pageblock 转换的开销取舍。
效益 分配器对「将映射」与「永不映射」两类页分开管理,unmapped 分配不再被可映射页的碎片策略拖累,分配与回收行为更可预期。
和你相关 关注内存分配器 / 碎片治理的同学值得跟进。
🔗 原文
★ MGLRU 想按「访问频率」提升页:MGLRU-FG(RFC v1,15 篇)
〔08-15 17:20 北京〕· mm · RFC PATCH v1 00/15
定位 mm 回收层的 MGLRU(多代 LRU):目前按「访问新旧」分代,同代内再提升不细分。
做法 Kairui Song 的 RFC 15 篇:frequency guided workingset promotion——给 MGLRU 加访问频率引导,让频繁被访问的页(即便同代)更该被当作工作集保住;讨论里在敲定 folio 引用计数宏的命名(LRU_REF_FAULT / LRU_REF_EXEC)。
效益 减少高频热页被误回收的抖动,工作集判断更接近真实访问模式。
和你相关 关注回收 / 工作集 / 内存压力的同学可参与 RFC 讨论。
🔗 原文
★ zswap 瘦身:固定数组引用池,收缩每个 entry(RFC v3)
〔08-15 14:54 北京〕· mm · RFC PATCH v3 0/3
定位 mm/zswap(压缩 swap 缓存):每个被压缩的页对应一个 struct zswap_entry,结构越胖,百万级 swap 下内存开销越明显。
做法 RFC v3 3 篇:把 zswap_pools 链表换成固定 pools 数组、entry 用下标引用池,从而精简 zswap_entry 字段;退役池用 call_rcu() 而非 synchronize_rcu() 释放。
效益 每 entry 省下指针等字段,海量 swap 场景整体内存占用下降,退役池回收也更顺滑。
和你相关 在意 swap / 内存开销的同学可关注。
🔗 原文
📰 net
/ column ★ TCP 通告 MSS 改从「配置的 MTU」取,不再被 PMTU 带偏
〔08-15 15:04 北京〕· net · PATCH v2 0/2
定位 TCP 路径:通告给对端的 MSS 以往按学到的 PMTU(路径 MTU)推算,可能与网卡配置的 MTU 不一致。
做法 v2 2 篇:改为从配置的 MTU 直接通告 MSS;附 packetdrill 用例覆盖「带 PMTU 例外」场景。
效益 MSS 通告与接口配置对齐,避免路径 MTU 波动时通告值错配导致的性能 / 分片问题。
和你相关 调优过 TCP / MTU 的同学可留意这个行为修正。
🔗 原文
★ 多 PHY 封装设备的探测顺序修了:fw_devlink 链上供应商
〔08-15 08:48 北京〕· net · PATCH net-next 0/3
定位 driver-core + net 跨界:一颗芯片封装里含多个以太网 PHY(PHY package),fw_devlink(固件设备依赖)的探测顺序可能让成员 PHY 抢在供应商之前。
做法 3 篇:driver core 抽出「只同步状态」的 link 清理;of: property 把 PHY package 供应商链到成员 PHY;mdio 在 population 完成后释放 fw_devlink 代理。
效益 多口 PHY / 封装设备开机探测顺序更稳,供应商依赖真正生效。
和你相关 做多口网卡 / 车载以太网 PHY 的同学可关注。
🔗 原文
📰 DRM
/ column ★ nouveau 收拾 GB20x 显示链路:infoframe / vblank / 超高频时钟(7 篇)
〔08-15 07:58 北京〕· DRM · PATCH 0/7
定位 drm/nouveau 显示路径(Blackwell 系 GB20x):HDMI / DP 输出到新卡的寄存器与固件接口各不一样。
做法 7 篇:新增 GB20x HDMI vendor infoframe 写入器、修 GCP AVMute 寄存器偏移与 vblank 中断;GSP 按固件版本选用 DP_CONFIG_STREAM 参数;支持 >2.147GHz 像素时钟编程;HF-EEODB EDID 转成 struct drm_edid。
效益 新一代 N 卡接 HDMI / DP 的信号正确性补齐,高分高刷场景稳定。
和你相关 用新 N 卡(Blackwell)显示的同学可关注。
🔗 原文
★ 新驱动 drm/tyr 上 GPU 复位基础设施(v4)
〔08-15 18:25 北京〕· DRM · PATCH v4 0/4
定位 新加速器驱动 drm/tyr(drivers/gpu/drm/tyr):作为新生驱动,先把软复位这种地基能力搭起来。
做法 v4 4 篇:软复位前清掉 stale IRQ 状态、iomem 访问挂到硬件 gate 后;顺带 rust: workqueue 给 OwnedQueue 补 Send/Sync 实现。
效益 驱动有了可依赖的 GPU 复位流程,后续功能可以踩在稳定地基上;Rust workqueue 抽象同步补安全标记。
和你相关 关注新 GPU / 加速器驱动与 Rust 抽象的同学可跟进。
🔗 原文
📰 media
/ column ★ 编码器 ROI 来了:关键区域给高质量(iris,v5)
〔08-16 03:22 北京〕· media · PATCH v5 0/5
定位 V4L2 视频编码(Qualcomm iris / venus 系):编码器没有「感兴趣区域(ROI)」控制,无法让画面关键区域享受更高码率。
做法 v5 5 篇:UAPI 新增 encoder ROI 控制;v4l2-core 落地;iris 驱动实现 HFI Gen2 编码器的 ROI delta QP + BUF_ROIMB_DELTAQP 元数据缓冲。
效益 视频通话 / 监控等场景可把资源集中在人脸 / 关键区域,同等码率下画质更好,或同等画质更省带宽。
和你相关 做视频编码 / 相机采集产品的同学可关注。
🔗 原文
★ vicodec / v4l2-mem2mem 修 4 处内存安全 bug
〔08-15 22:56 北京〕· media · PATCH 0/4
定位 V4L2 内存到内存(mem2mem)框架 + vicodec 虚拟编解码器:几处尺寸处理与并发边界粗糙。
做法 4 篇:REMOVE_BUFS 与 job 执行串行化、S_FMT 可见尺寸 clamp 到 coded 边界、修下取整后 coded 尺寸的越界写、编码器 CAPTURE 尺寸改只读。
效益 mem2mem 设备边界更稳,越界写风险消除——虚拟设备常是框架的试金石。
和你相关 基于 vicodec / mem2mem 做开发的同学建议跟进。
🔗 原文
📰 block
/ column ★ O_DSYNC 直写不再做多余的 flush(v2)
〔08-15 17:07 北京〕· block · PATCH v2 0/2
定位 块层直写路径:O_DSYNC(要求数据落盘)的直写,在设备已支持 FUA(强制写穿缓存)时,仍可能触发冗余的 flush 请求。
做法 v2 2 篇:设备支持 FUA 时 O_DSYNC 直写直接用 FUA;同时只在设备确实支持时才用 REQ_FUA,避免错误语义。
效益 省掉多余 flush,O_DSYNC 直写延迟与写放大双降,数据库 / 日志型负载受益。
和你相关 跑数据库 / 追求写延迟的同学可关注。
🔗 原文
📰 sched
/ column ★ CFS 负载均衡想更「实时」:LB_PROMOTE 系列(10 篇)
〔08-15 19:04 北京〕· sched · PATCH 00/10
定位 CFS 负载均衡路径:fair 任务在负载均衡里容易被「顺路处理」,得不到及时迁移,响应变差。
做法 10 篇:新增 LB_PROMOTE 特性——newly idle 时尽力找任务迁移、active balance 触发条件放宽、引入 select_task_rq_fair_thin() 快速选 rq 等,目标是在均衡的同时提升 CFS 任务的实时响应。
效益 CFS 任务被迁移 / 唤醒的路径更积极,延迟敏感型负载的响应更稳。
和你相关 关注调度 / 延迟敏感负载的同学可跟踪这一波均衡改动。
🔗 原文
📰 PCI
/ column ★ 关机不关电?pci_device_shutdown() 把设备又唤醒了(~19W)
〔08-16 03:25 北京〕· PCI · 问题报告
定位 PCI 电源管理路径:pci_device_shutdown() 在系统关机时会把先前已挂起的设备重新 resume,导致设备在 S5(软关机)状态仍在耗电。
做法 当前是问题报告 + 讨论阶段:实测某场景关机后待机功耗约 19W,怀疑与 shutdown 路径 resume 行为有关,社区在定位是否该在 shutdown 时保持挂起。
效益 若能修好,笔记本 / 桌面软关机后的待机功耗显著下降,电池与电费都受益。
和你相关 在意关机待机功耗的同学可关注这条追踪。
🔗 原文
📌 机制雷达:跨域大改动
/ section negative dentry VFS 治负目录项:refcount 溢出 + d_children 遍历软锁死,公共迭代器 + 游标调度 · 原文 bpf_ksock BPF kfunc 让程序自建 UDP socket 发遥测,Tetragon / Meta 场景,已合入 bpf-next · 原文 x86 vzeroupper ebiggers 补 6 处缺失 vzeroupper(xor / raid6 / aria / nft pipapo 的 AVX 代码),清 AVX 状态、消切换惩罚 · 原文 futex/pi tip locking/urgent 堵私有 futex 的 exec() 竞态 + 初始 phash.ref 分配竞态 · 原文 driver core reprobe mxl862xx DSA 系列顺手给 driver core 加 device_schedule_reprobe(),probe 结果可调度重试 · 原文 BPF × LSM lsm: add bpf_security_locked_down() kfunc,BPF 程序能查内核 locked_down 状态 · 原文
○ 更多动态
/ column
📖 本期概念速查
/ section negative dentry 路径查找失败后缓存的「不存在」目录项记录,加速重复查找;海量堆积会带来内存与遍历问题
dentry 目录项(directory entry)内核对象,路径解析的缓存节点,分正(存在)负(不存在)两种状态
kfunc 允许 BPF 程序直接调用的内核导出函数,bpf_ksock 就是用一组 kfunc 把 socket 能力暴露给 BPF
vzeroupper x86 AVX 状态清理指令:从 AVX 切回 SSE 时清空 YMM 高 128 位,避免切换惩罚与状态残留
MGLRU 多代 LRU:内存回收按「代」组织页面、跨代比较新旧,比传统单 LRU 更抗扫描
freetype / direct map 页分配器按用途分类的空闲类型(free type);direct map 是内核把物理内存直接映射到虚拟地址空间的窗口,unmapped 页绕开它
O_DSYNC 写文件要求数据持久化的标志——每次写都要保证落盘;块层对它合并 flush 能省大量刷盘
FUA Force Unit Access,强制写穿设备缓存写回介质的写请求语义,省掉独立 flush 指令
VFS 先把最疼的两个症状摁住,BPF 学会了自己对外说话——今天的地基又厚了一层。
数据来源:lore.kernel.org(全内核 13 列表)· 北京时间
💬 评论
使用 GitHub 账号登录即可留言