过去一年,AI 圈比的是模型谁更强;昨晚 DeepSeek 开源了 DeepSeek Harness(DSH)——第一次把手伸到「模型输出之后」的执行层。模型决定智能上限,Harness 决定实际表现,竞争的战场正在切换。
🎯 核心判断
/ section🔍 事件还原:两天,两块拼图
/ section8 月 13 日早些时候,DeepSeek-V4-Pro 正式上线 App/Web/API(模型号 DeepSeek-V4-Pro-0813):1M Token 上下文、最高 384K Token 输出,官方重点强调 Agent 能力——Terminal Bench 2.1 达 87.9,DeepSWE 62.7,Toolathlon-Verified 74.1,DSBench-FullStack 71.1。当晚,DeepSeek Harness 开源发布,npx @deepseek-ai/dsh web 即可本地起 Web UI(GitHub:deepseek-ai/deepseek-harness)。
这其实早有预兆:7 月 31 日 V4 Flash 发布时,更新日志里就埋着一行——公开 Code Agent benchmark 使用的测试框架,正是「即将发布」的 Harness 极简模式。也就是说,Harness 在正式公开之前,已经在参与评估 DeepSeek 自己模型的 Agent 能力了。
🧩 源码架构拆解:七层 + 一条闭环
/ section架构分析直接读 @deepseek-ai/dsh 0.1.0-rc.6 源码,不走文档转述。从宏观到微观,DSH 分七层——入口(dsh CLI)→ Profile 层(插件组合包)→ 插件宿主(Cordis)→ 核心运行时(dsh-base)→ 工具面 → 模型适配 → 持久化;一条任务沿这条链路跑一个闭环,事件全程落盘、可重建。
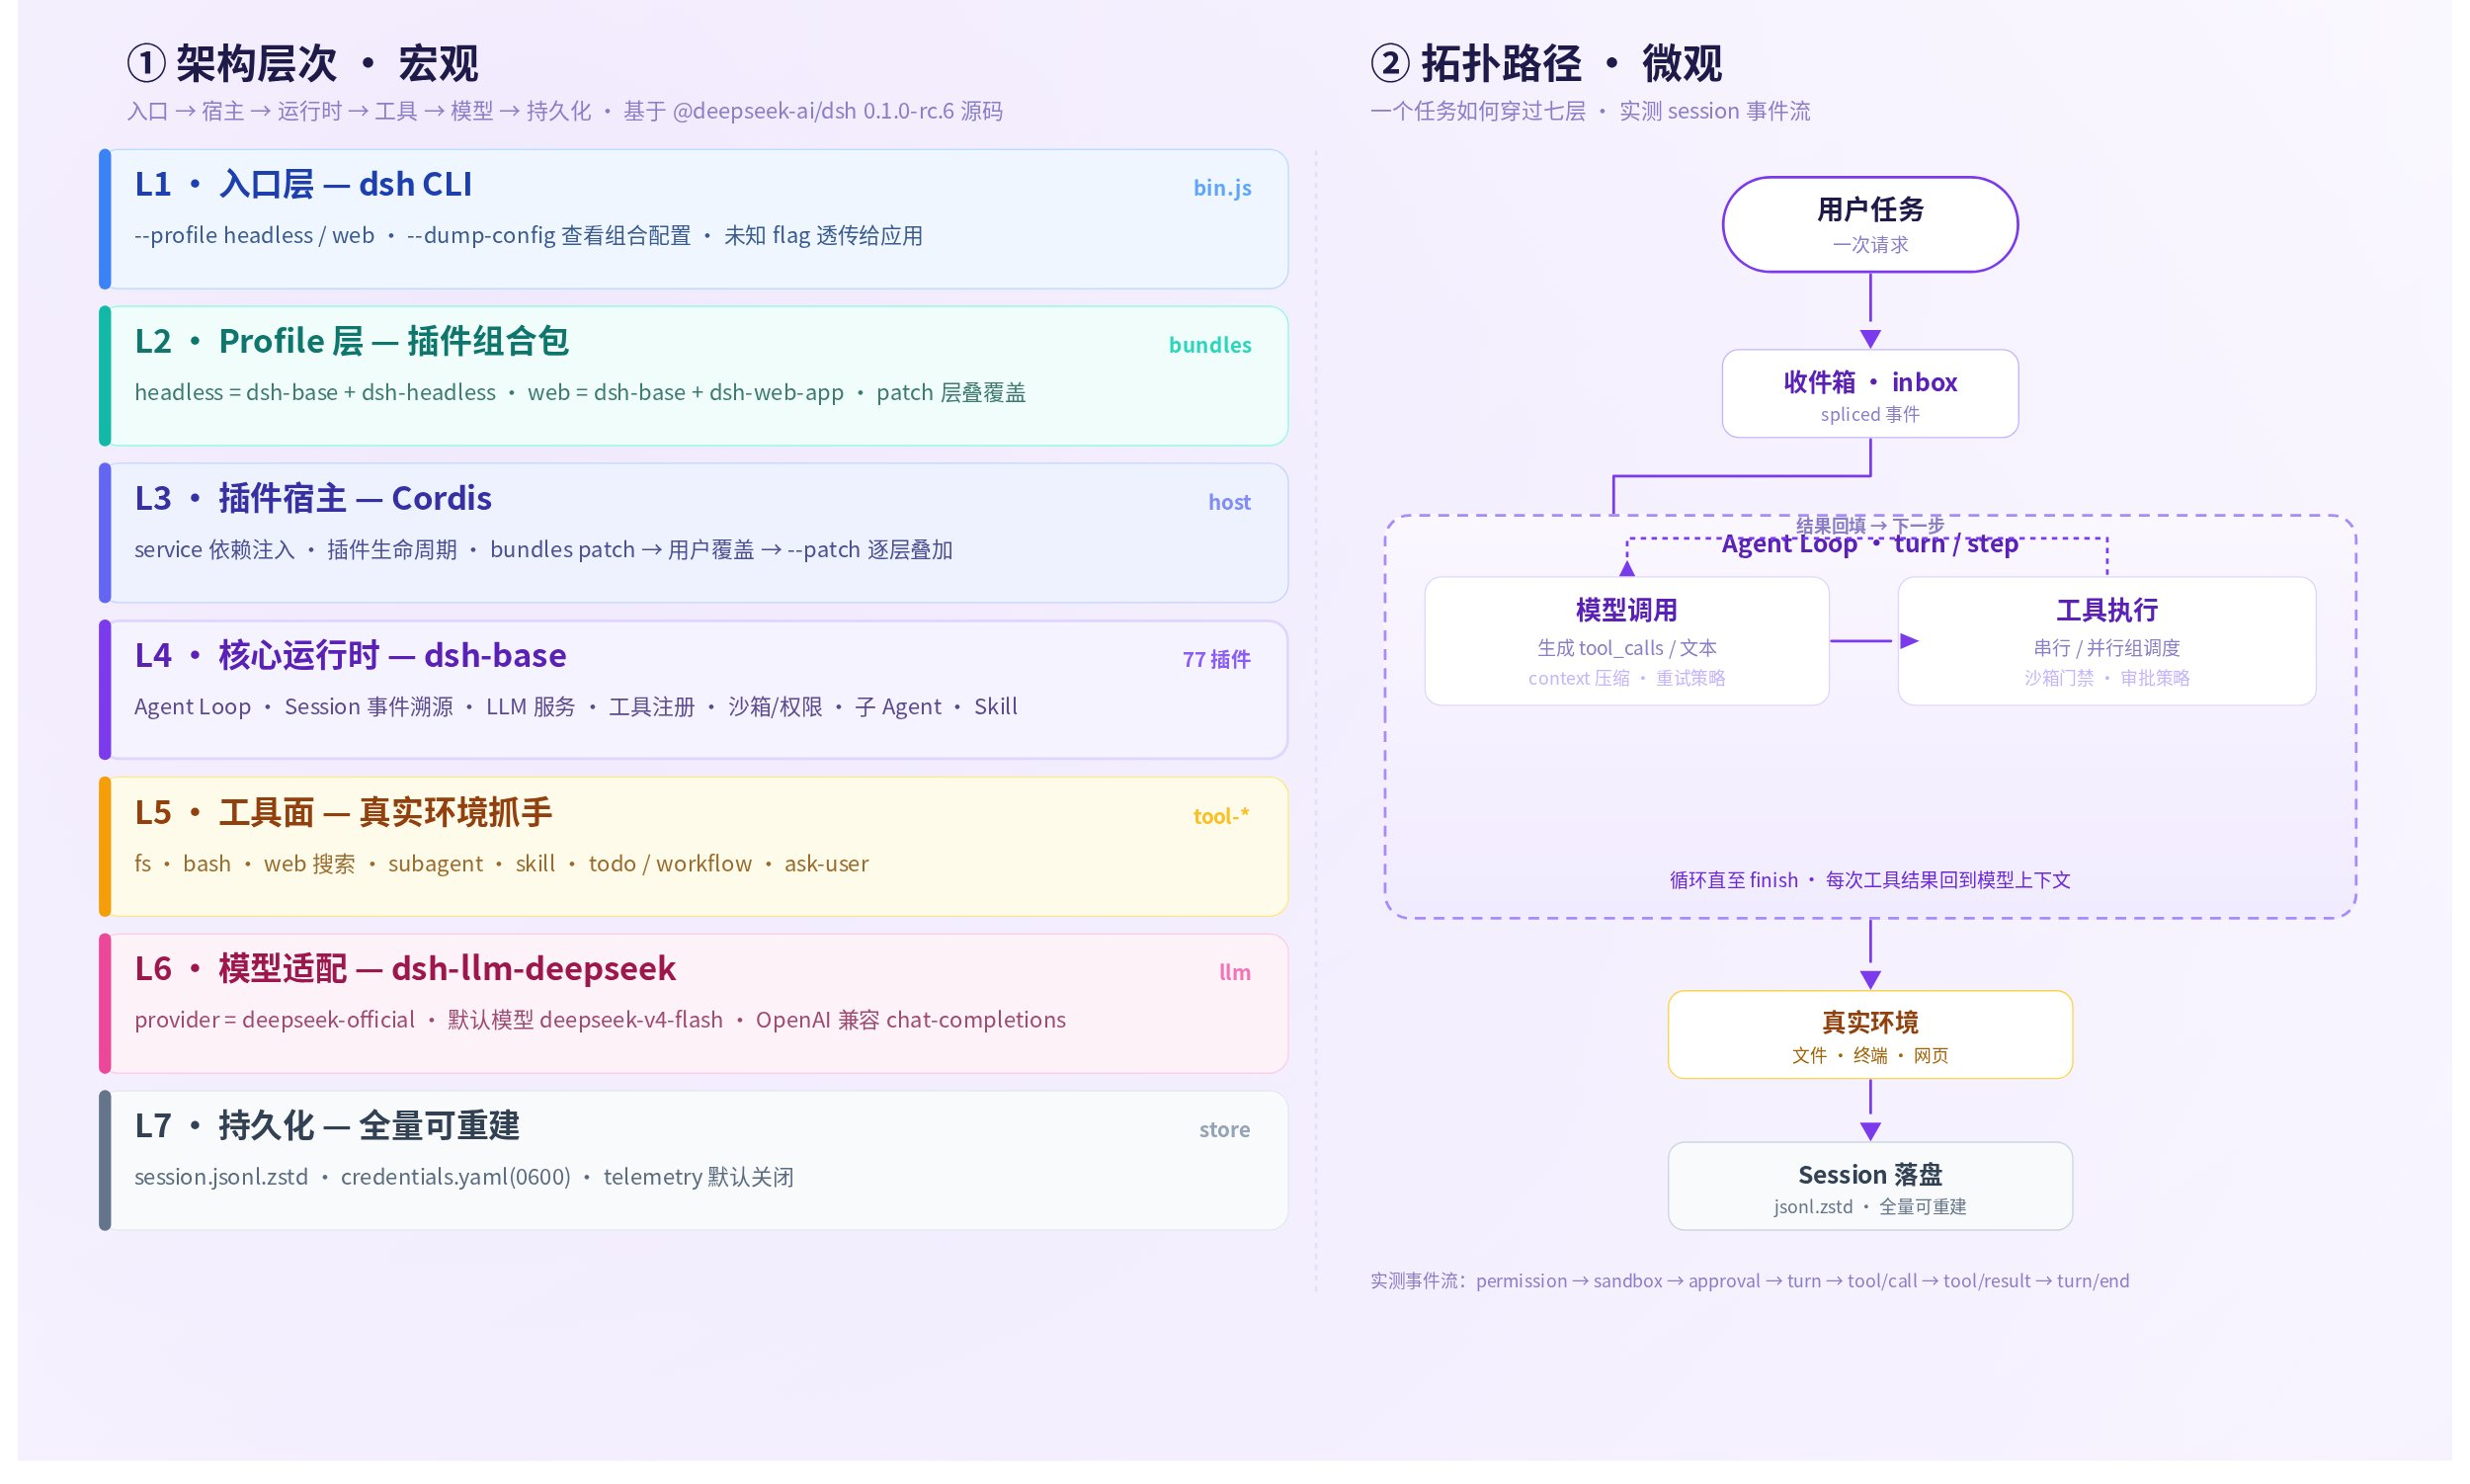
★ 宏观 · 七层架构(源码实证)
★ 微观 · 一条 Agent 闭环
Everything is a plugin——模型、文件系统、Shell、网页、Skill、子 Agent、交互界面全可替换;预设(标准/PTC/极简/创造)和形态(Web/TUI/Headless/ACP/SDK)只是同一套底层的不同组合。但读源码后最硬的一条判断:DeepSeek 的 V4 在公开 Code Agent benchmark 上用的就是 Harness 自己——模型和执行层是同一套体系联合设计,不是配套,是同源焊接。
⚔️ 竞争格局:执行层开战
/ section🔬 为什么 Coding 是试金石
/ sectionAI Coding 正成为观察与训练 Agent 能力最理想的场景:代码反馈密集且客观——能不能编译、测试过不过、报错是什么,机器可直接验证,Agent 得以形成「执行→反馈→修改→再执行」的闭环。而 DSH 的 Session Log 要求「模型真正看到的一切都能从日志重建」(用户消息 / 模型请求 / 工具调用 / 上下文压缩 / 权限变化):既能恢复、回放、调试、审计,也让 Agent 执行过程第一次变得可系统化记录与分析——这正是评估 Agent 能力的实验场。
🎯 对我们的启示
/ section模型决定智能的上限,Harness 决定它能否真的开始工作。
数据来源:DeepSeek 官方(GitHub / npm / api-docs 更新日志)· 追踪视角
💬 评论
使用 GitHub 账号登录即可留言